3장 2040년 자장면 가격 예측
어떤 과정으로 해결할까?
인공지능(기계학습)으로 2040년 자장면 가격을 예측하는 문제의 해결과정은 다음과 같습니다.
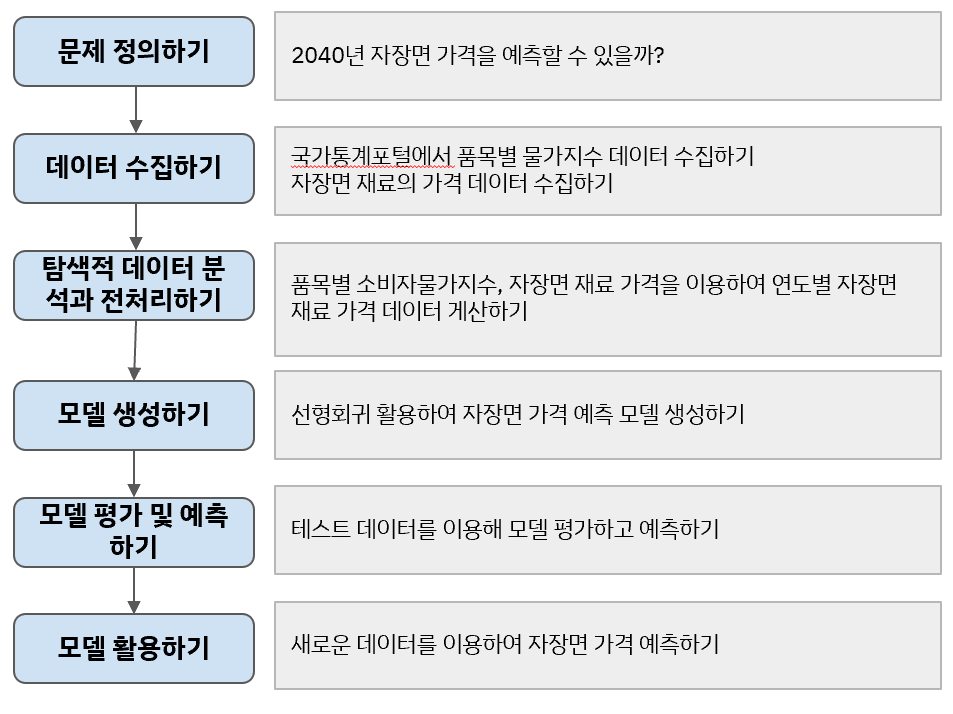
선형회귀(Linear Regression), 상관계수(Correlation Coefficient)
1. 문제는 무엇인가?
2022년 6월 통계청 국가통계포털(KOSIS)에 따르면 치킨의 소비자물가가 전년 동월 대비 10.9% 오른 것으로 나타났습니다. 외식 품목 중 자장면(10.4%)도 두 자릿수 상승률을 기록했습니다.
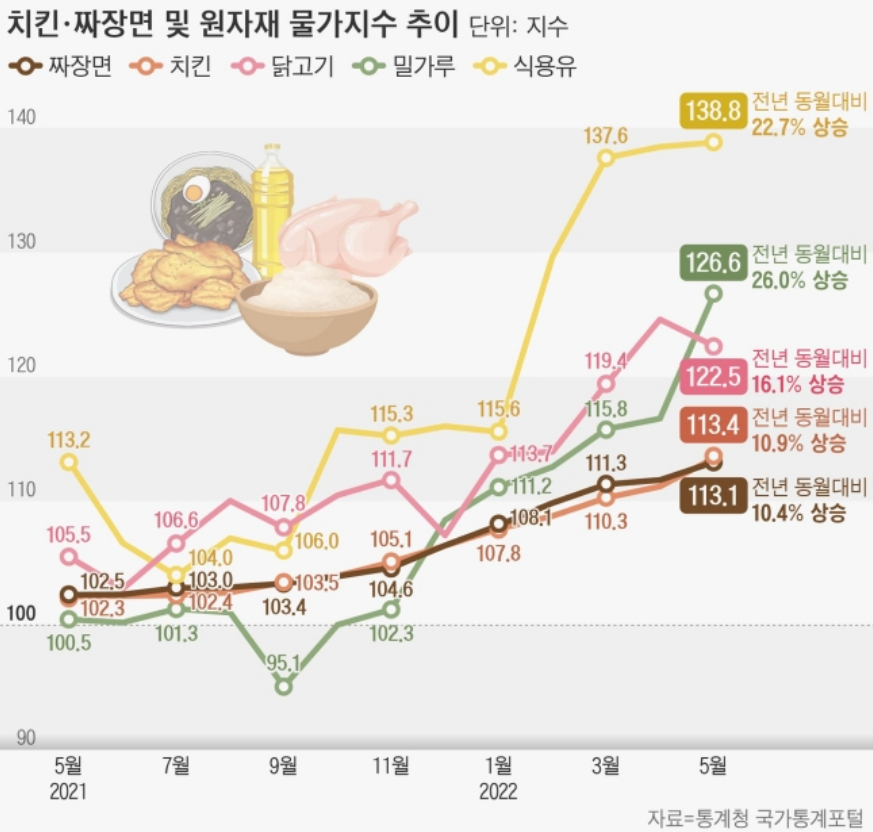
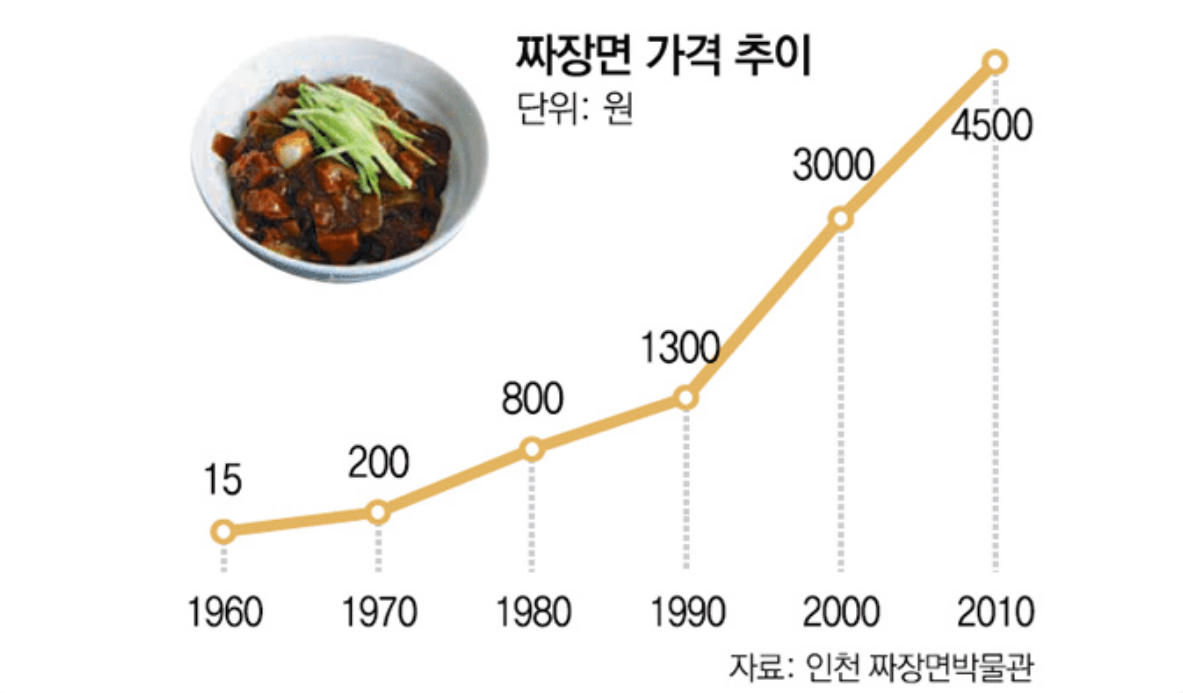
[그림 3-1] 자장면 물가 추이
[출처] 조선비즈 뉴스 2022.06.12.일자 https://n.news.naver.com/mnews/article/366/0000820227
2040년 자장면 가격을 예측할 수 있을까?
2. 데이터는 어떻게 수집할까?
[1] 품목별 소비자물가지수 데이터 수집하기
연도별 자장면 가격 데이터를 준비하기 위해 국가통계포털에서 품목별 소비자물가지수 데이터를 수집합니다. 국가통계포털에서 제공하는 소비자물가지수는 2020년을 기준으로 합니다. 연도별 자장면 소비자물가지수와 기준 연도인 2020년 자장면 가격 데이터를 수집하여 계산하면 연도별 자장면 가격을 구할 수 있습니다.
- 국가통계포털(https://kosis.kr/)에서 ‘품목별 소비자물가지수’를 검색하면 다음과 같은 리스트가 나타납니다.
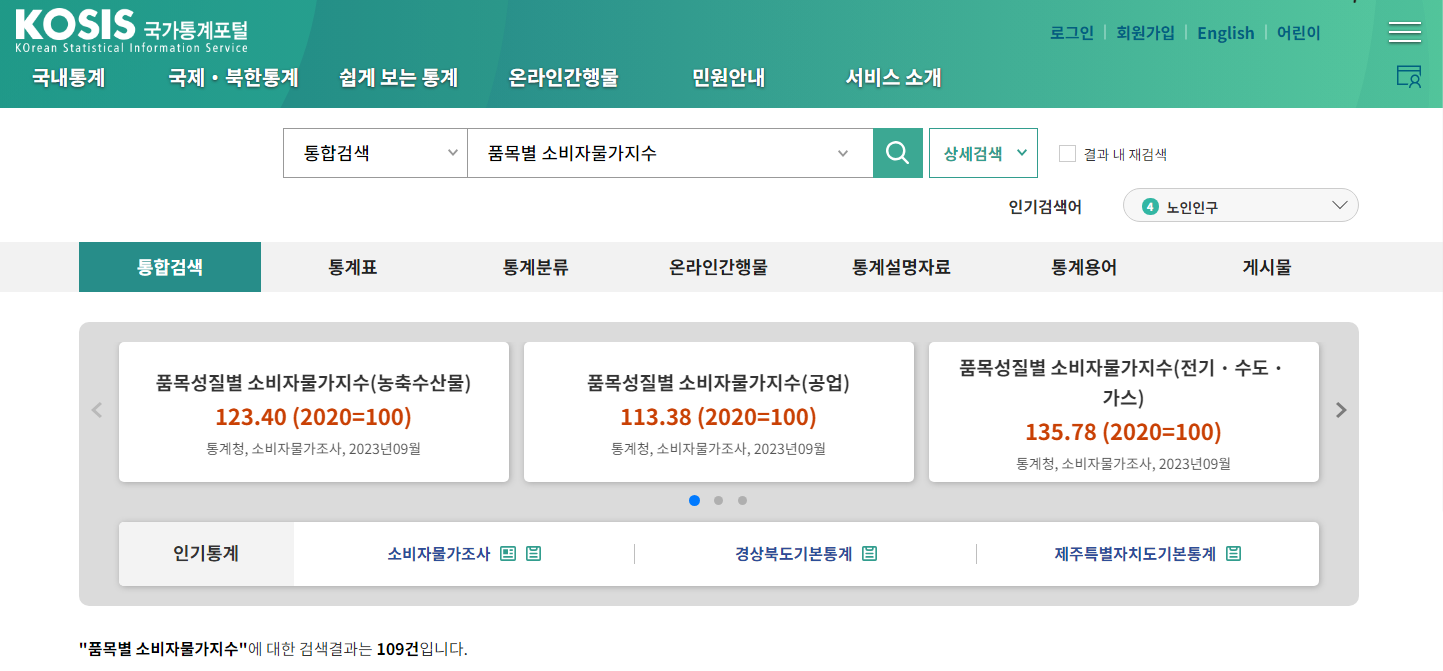
다음의 품목별 소비자물가지수 중 첫 번째 항목을 선택합니다. (2020=100)은 기준년도 2020년의 소비자물가지수가 100이라는 의미입니다.
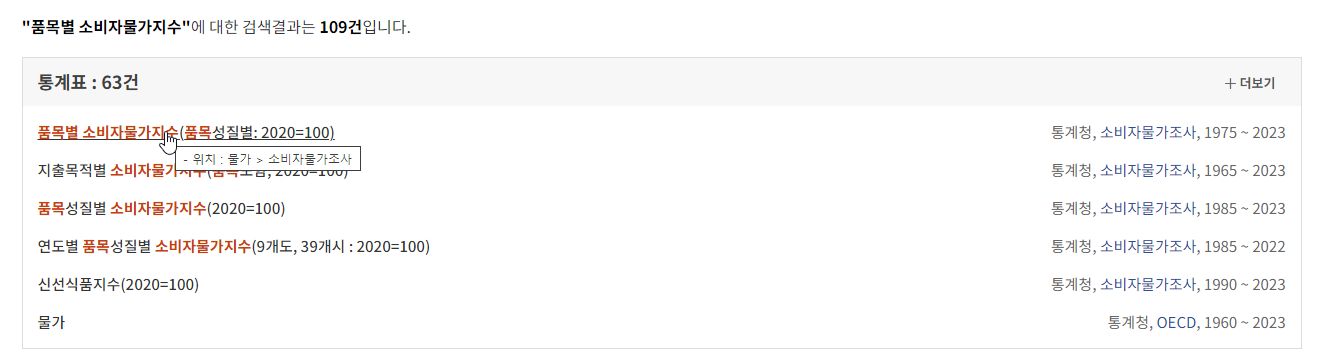
- 검색된 결과에서 품목별 소비자물가지수를 선택하면 다음과 같은 화면이 나타납니다.
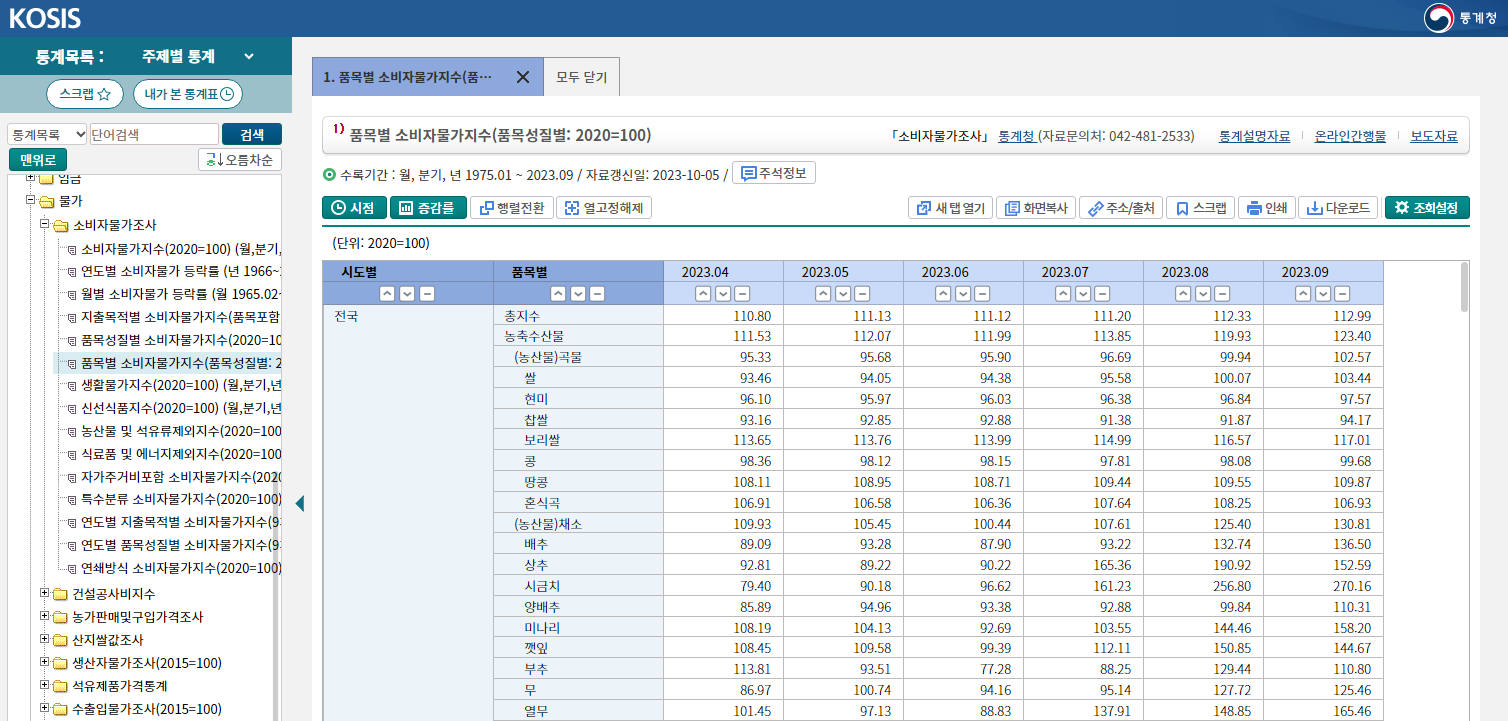
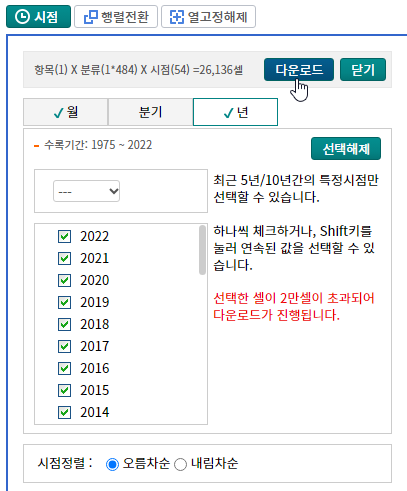
- 검색된 [품목별 소비자물가지수] 창에서 연도별 소비자물가지수 데이터를 다운로드합니다. 다음과 같은 화면에서 [시점]을 선택합니다. 새 창에서 ‘년’ 탭을 선택하고 [전체 선택]을 누르면 1975년부터 2022년까지 모든 연도에 체크되며, ‘다운로드’를 클릭해 품목별 소비자물가지수를 다운로드합니다.
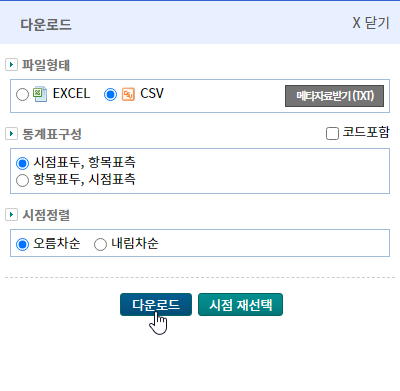
- 다운로드 파일 형태를 ‘CSV’로 선택하고 ‘다운로드’를 클릭합니다.
다운로드한 파일을 열어보면 다음과 같이 여러 품목의 소비자물가지수가 하나의 파일에 저장되어 있습니다. 소비자물가지수는 2020년을 기준으로 100으로 설정되어 있고, 다른 연도는 기준 연도의 상대적인 지수를 나타냅니다. 여기에 나타난 소비자물가지수는 우리가 원하는 자장면 가격 데이터가 아닙니다.
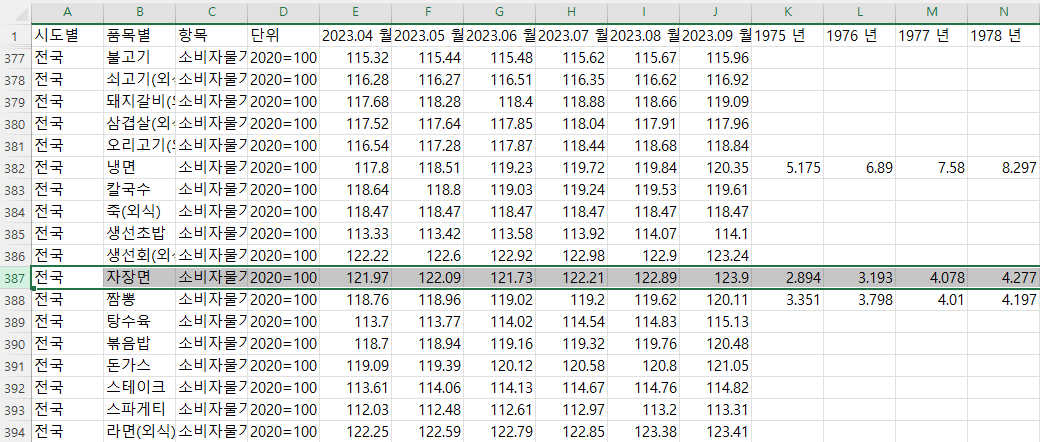
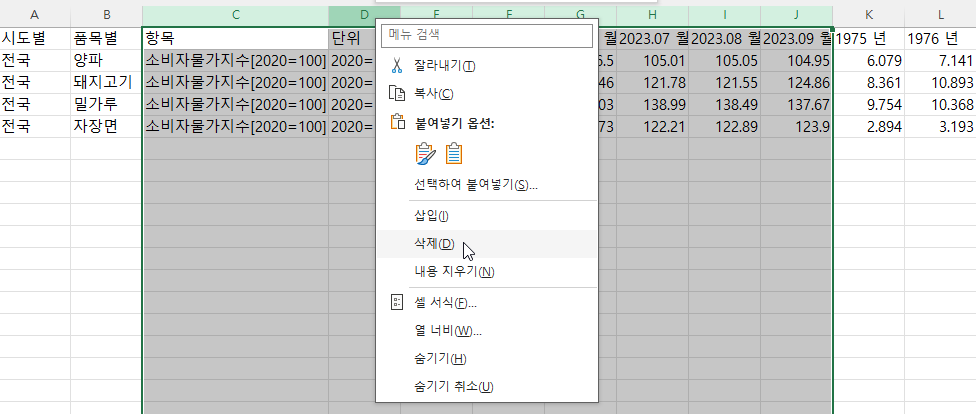
- 이렇게 수집한 데이터 파일에서 자장면, 밀가루, 돼지고기, 양파의 소비자물가지수만 추출하고 필요하지 않은 셀은 그림과 같이 삭제합니다. 왼쪽의 ‘시도별’ 열도 같은 방법으로 삭제합니다.
이렇게 편집한 데이터는 그림과 같이 4가지 품목의 소비자물가지수로 이루어져 있습니다.
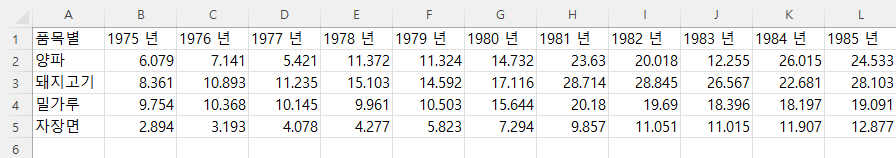
데이터 분석을 위해 연도, 돼지고기, 밀가루, 자장면 소비자물가지수가 데이터의 속성(열)이 될 수 있도록 행/열 변환을 수행합니다.
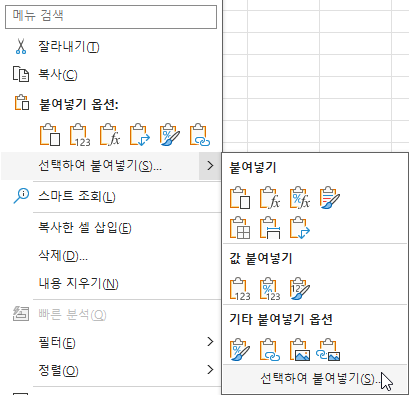
- 총 5줄로 이루어져 있는 데이터를 전체 복사하여 [A6] 셀에 [선택하여 붙여넣기]합니다. 그런 다음 그림과 같은 창에서 [행/열 바꿈]을 선택합니다.
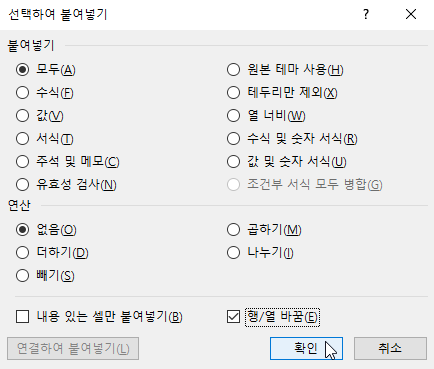
- 행/열 변환 후 필요 없는 데이터는 지우고 데이터를 다음과 같은 형태로 정리합니다.
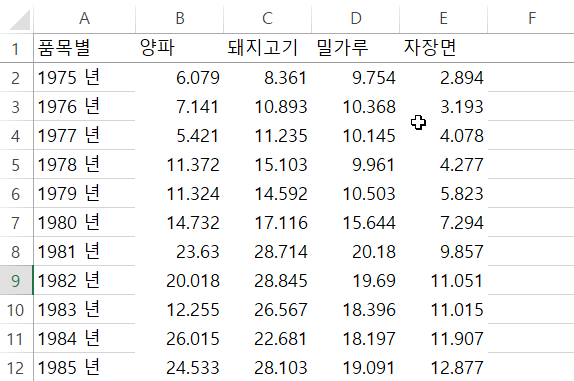
- 마지막으로 ‘품목별’이라는 값이 속성명으로 적절하지 않기 때문에 ‘연도’로 수정합니다. 그리고 데이터 분석을 위해 ‘1975년’과 같이 문자열로 저장된 연도 값을 ‘1975’의 수치 데이터로 변환합니다. 그림과 같이 [A2] 셀에 숫자 ‘1975’을 입력하고 셀을 선택한 상태에서 <Ctrl>키를 누르고 + 기호를 드래그하면 연속적으로 변화하는 수치로 바뀝니다.
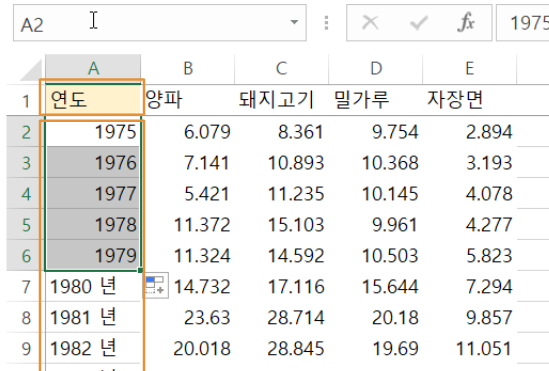
이렇게 편집한 1975년부터 2022년까지 연도별 자장면 재료의 물가지수 데이터를 ‘소비자물가지수(1975-2022).csv’ 파일로 저장합니다. 정리한 파일은 아래의 표와 같습니다.
[표 3-1] 2020년 자장면 재료별 소비자물가지수
연도 양파 돼지고기 밀가루 자장면 1975 6.08 8.36 9.75 2.89 1976 7.14 10.89 10.37 3.19 1977 5.42 11.24 10.15 4.08 1978 11.37 15.10 9.96 4.28 1979 11.32 14.59 10.50 5.82 1980 14.73 17.12 15.64 7.29 1981 23.63 28.71 20.18 9.86 1982 20.02 28.85 19.69 11.05 1983 12.26 26.57 18.40 11.02 1984 26.02 22.68 18.20 11.91 1985 24.53 28.10 19.09 12.88 1986 19.11 30.76 20.35 13.48 ... ... ... ... ... 2018 80.86 93.98 99.40 94.98 2019 68.75 90.31 101.07 98.59 2020 100.00 100.00 100.00 100.00 2021 103.56 111.11 100.67 103.07 2022 94.42 120.09 128.83 114.20
[2] 자장면 재료 가격 탐색하기
국가통계포털에서 다운로드한 자료는 품목별 소비자물가지수이기 때문에 자장면 가격 데이터는 아닙니다. 연도별 자장면 재료의 가격 데이터를 얻을 수 없는 경우, 기준 연도의 가격을 알면 소비자물가지수 값을 이용하여 계산할 수 있습니다. 이를 위해서는 물가지수 기준(100)이 되는 2020년 자장면 재료의 가격 데이터를 수집해야 합니다. 한국소비자원 참가격 사이트(https://www.price.go.kr/)의 ‘외식비’ 페이지에서 2020년 자장면 가격, 양파 가격, 돼지고기 가격, 밀가루 가격 데이터를 얻을 수 있습니다.
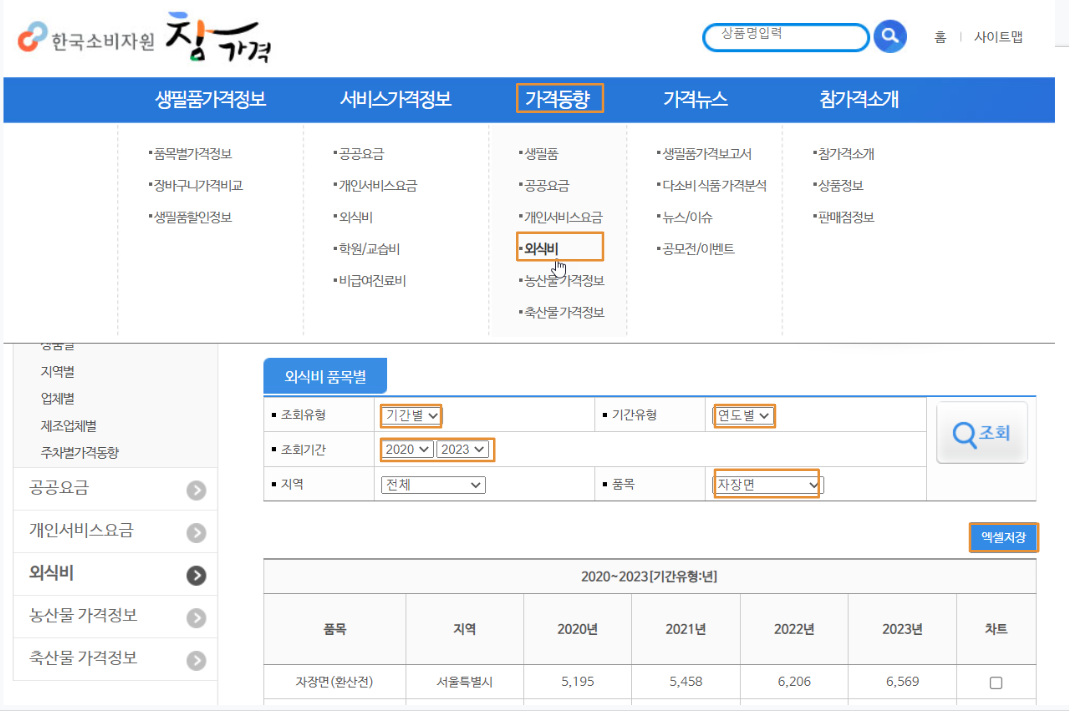
또한 축산물품질평가원(https://www.ekapepia.com/)에서 2020년 돼지고기 평균가격을 구할 수 있습니다. 여기서는 자장면 재료로 사용될 수 있는 목심 부위의 가격을 조사하였습니다. 상단 메뉴에서 ‘소비자가격’ -> ‘기간별가격’ -> ‘월별가격’을 선택하고, 조회 기간과 축종, 부위/규격을 선택합니다.
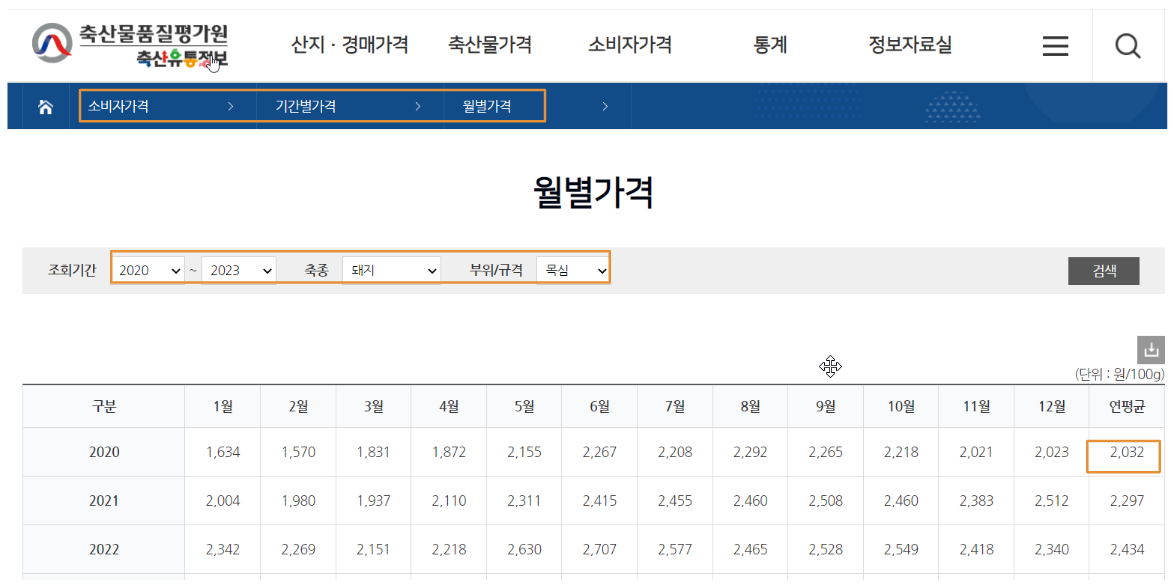
위와 같은 방법으로 자장면을 만드는 데 필요한 밀가루, 양파, 돼지고기의 월별 가격을 정리하면 다음과 같습니다. 이 데이터를 ‘자장면재료가격2020.csv’로 저장합니다.
[표 3-2] 2020년 자장면 재료별 소비자가격
| 월별 | 양파 가격(1.5kg) | 돼지고기 가격 | 밀가루 가격(1kg) | 자장면 가격 |
| 2020년 | 3761.1 | 2032.0 | 1356.2 | 5195.2 |
[표 3-1]의 ‘자장면 재료별 소비자물가지수’ 데이터와 [표 3-2]의 자장면 재료별 소비자가격을 이용하면 연도별 자장면 가격을 계산할 수 있습니다.
3. 어떤 데이터 처리가 필요할까?
자장면 가격을 예측하는 인공지능 모델을 만들어야 하기 때문에 소비자물가지수를 가격 데이터로 변환해야 합니다. 연도별 물가지수와 기준이 되는 2020년 품목별 가격 데이터를 이용하면 연도별 자장면 재료의 가격을 계산할 수 있습니다.
[그림 3-2] 연도별 자장면 가격 계산을 위한 전처리
(편집자주: 그려주세요)
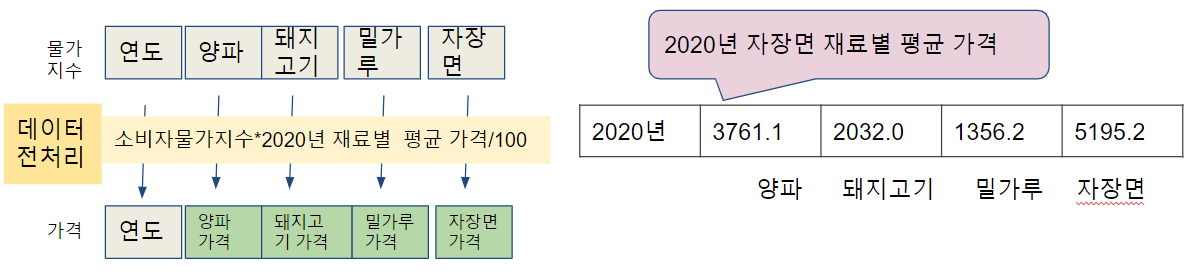
소비자물가지수 데이터를 가격 데이터로 변환하는 과정은 다음과 같습니다.
...
2020년 자장면 가격 = (2020년 자장면 평균 가격 * 2020년 자장면 소비자물가지수) / 100
2021년 자장면 가격 = (2021년 자장면 평균 가격 * 2021년 자장면 소비자물가지수) / 100
...
이와 같은 방법으로 연도별 소비자물가지수를 2020년 자장면 재료의 평균 가격을 이용하여 1975년부터 2022년까지 자장면 재료의 가격을 구할 수 있습니다.
[표 3-3] 연도별 자장면 재료 가격
| 연도 | 양파 가격 | 돼지고기 가격 | 밀가루 가격 | 자장면 가격 |
| 1975 | 228.64 | 169.90 | 132.28 | 150.35 |
| 1976 | 268.58 | 221.35 | 140.61 | 165.88 |
| 1977 | 203.89 | 228.30 | 137.59 | 211.86 |
| 1978 | 427.71 | 306.89 | 135.09 | 222.20 |
| 1979 | 425.91 | 296.51 | 142.44 | 302.52 |
| 1980 | 554.09 | 347.80 | 212.16 | 378.94 |
| 1981 | 888.75 | 583.47 | 273.68 | 512.09 |
| 1982 | 752.90 | 586.13 | 267.04 | 574.12 |
| 1983 | 460.92 | 539.84 | 249.49 | 572.25 |
| 1984 | 978.45 | 460.88 | 246.79 | 618.59 |
| 1985 | 922.71 | 571.05 | 258.91 | 668.99 |
| … | … | … | … | … |
| 2020 | 3761.10 | 2032.00 | 1356.20 | 5195.20 |
| 2021 | 3895.00 | 2257.76 | 1365.29 | 5354.69 |
| 2022 | 3551.23 | 2440.23 | 1747.19 | 5932.92 |
데이터 전처리를 통해 기계학습에 사용할 데이터는 총 5개의 속성을 가지고 있습니다.
[표 3-4] 자장면 가격 데이터 속성과 의미
| 속성 | 의미 |
| 연도 | 1975년~2022년 |
| 양파 가격 | 양파 1.5kg 가격 |
| 돼지고기 가격 | 돼지고기 목살 100g 가격 |
| 밀가루 가격 | 밀가루 1kg 가격 |
| 자장면 가격 | 자장면 1그릇 가격 |
4. 자장면 가격 예측 모델은 어떻게 만들까?
앞서 수집한 데이터를 이용하여 2030년 자장면 가격을 예측하는 모델은 어떻게 구현할 수 있을까요?
1975년부터 2022년까지 가공한 데이터를 활용하여 자장면 가격을 예측하는 모델을 구현하기 위해 데이터셋에서 데이터 속성의 역할을 설정해야 합니다. 총 5개의 속성 중 연도와 재료 가격은 독립변수(feature), 자장면 가격은 종속변수(target)로 지정합니다.
[표 3-5] 자장면 가격 데이터의 특징과 레이블
| 독립변수(feature) | 종속변수 (target) | |||
| 연도 | 양파 가격 | 돼지고기 가격 | 밀가루 가격 | 자장면 가격 |
| 1975 | 228.64 | 169.70 | 132.28 | 150.35 |
| 1976 | 268.58 | 221.09 | 140.61 | 165.88 |
| 1977 | 203.89 | 228.03 | 137.58 | 211.86 |
[그림 3-3] 자장면 가격을 예측하기 위한 독립변수와 종속변수
(편집자주: 그려주세요)
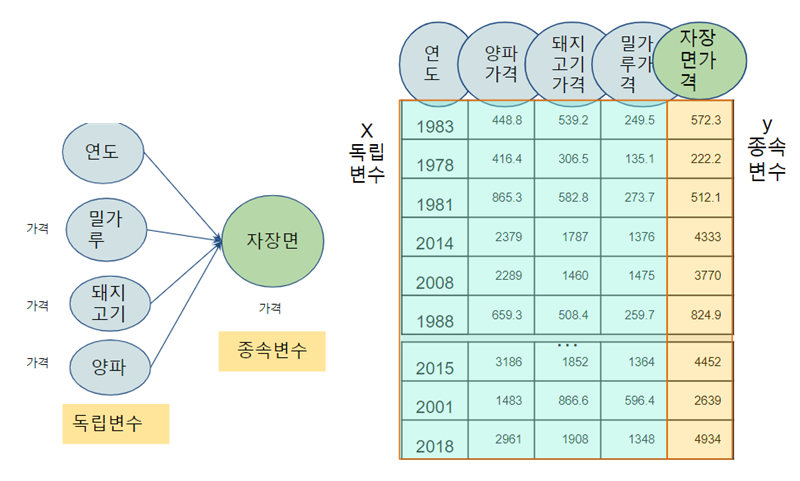
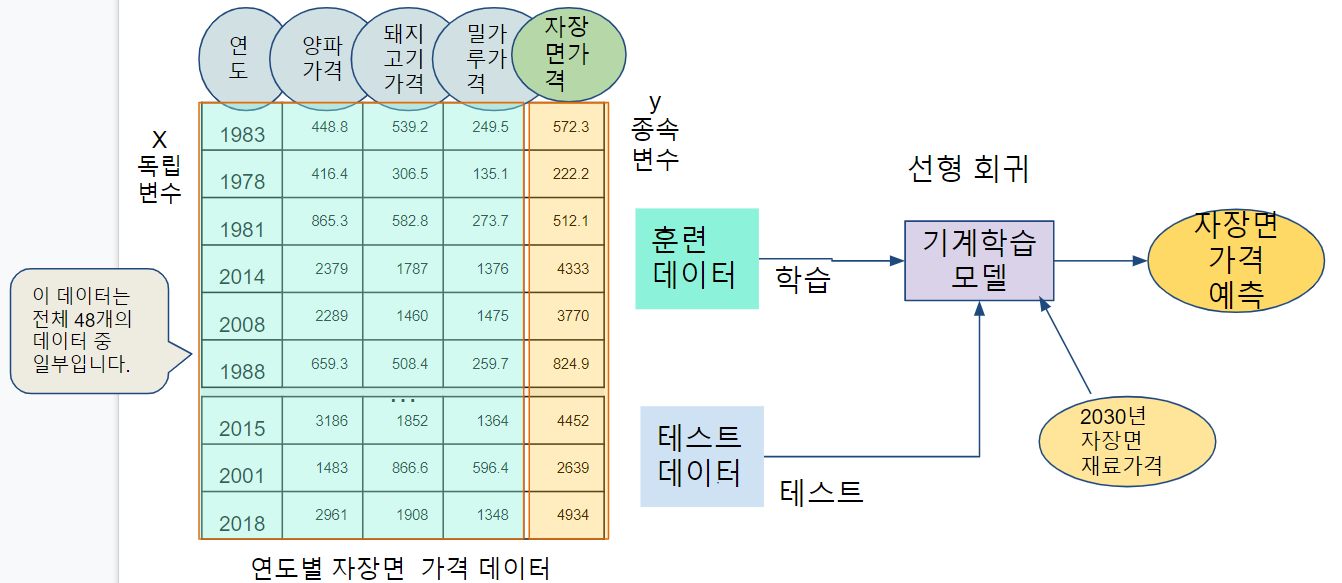
자장면 가격을 예측하는 문제는 종속변수가 수치형 데이터이기 때문에 선형회귀 모델을 구현하여 문제를 해결하는 것이 적합합니다. 자장면 가격을 예측하는 선형회귀 모델은 다음과 같은 형태로 동작합니다. 그림에서 연도, 밀가루 가격, 돼지고기 가격, 양파 가격 등을 독립변수로 설정하고 자장면 가격을 종속변수로 설정하여 자장면 가격을 예측하는 다중 회귀 모델을 만들 수 있습니다.
이 데이터는 전체 48개의 데이터 중 일부입니다.
[그림 3-4] 연도와 재료에 따른 자장면 가격 예측 모델의 동작
(편집자주: 그려주세요)
(더 배우기)
쉽게 배우는 AI 지식: 선형회귀
| 선형회귀는 한 개 이상의 독립변수(x)와 종속변수 y의 선형 관계를 모델링하는 분석 기법입니다. 기계학습 모델을 구현할 때 실제값과 예측값의 차이, 즉 오차를 최소로 하는 모델을 선택하는 것이 중요합니다. 선형회귀에서 오차를 최소로 하는 모델을 만들어 가는 과정은 다음과 같습니다. |
| [그림 3-5] 선형 회귀 모델링 과정 (편집자주: 그려주세요) 선형회귀 모델은 로 표현할 수 있습니다. 한 개의 설명 변수로 모델을 만들 경우 단순 선형 회귀, 둘 이상의 설명 변수의 선형관계를 바탕으로 모델을 만드는 경우 다중 선형회귀라고 합니다. 3개의 독립변수를 특성으로 하는 다중 선형회귀 모델은 로 표현될 수 있습니다. 선형회귀 모델의 학습은 훈련 데이터를 이용하여 비용을 최소로 하는 회귀계수(w)와 절편(b)의 값을 추정하는 것입니다. 가중치와 편향에 따라 선형회귀 모델의 예측값이 달라집니다. 훈련 데이터를 이용해 최소제곱법으로 손실을 최소로 하는 w와 b를 구할 수 있습니다. 최소제곱법은 오차의 제곱합이 최소가 되는 추정량을 구하는 방법입니다. |
5. 오렌지3를 활용한 선형회귀 모델 구현하기
오렌지3(Orange3)를 이용하여 자장면 가격을 예측하는 선형회귀 모델을 구현해 봅시다.
[1] 데이터 불러오기
| ① ‘File’ 위젯을 선택합니다. ② 위젯을 더블클릭하고 자장면 소비자물가지수 파일을 불러옵니다. - 파일 : 자장면소비자물가지수(1975-2022).csv |
자장면 소비자물가지수 데이터에 2020년 자장면 재료의 평균을 이용하여 계산합니다.
| ③ ‘File’ 위젯에 ‘Data Table’ 위젯을 연결하고 ‘Data Table' 위젯을 더블클릭하면 새 창에서 소비자물가지수 파일에 저장된 내용을 확인할 수 있습니다. |
[2] 데이터 전처리와 탐색하기
2.1 자장면 재료별 가격 구하기
자장면 소비자물가지수 데이터에 2020년 자장면 재료별 소비자가격을 이용하여 계산하면 자장면 재료별 가격을 구할 수 있습니다.
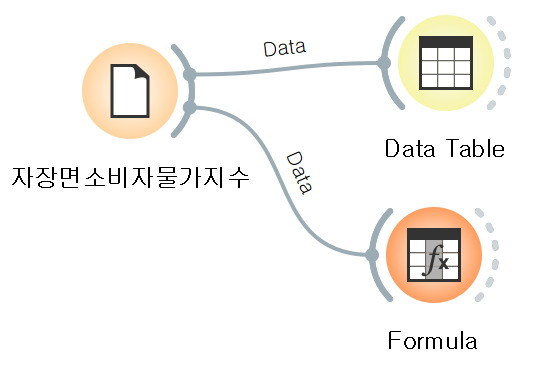
- ‘Transform’ 카테고리에서 ‘Formula’ 위젯을 선택하고, 캔버스에서 ‘File’ 위젯과 ‘Formula’ 위젯을 연결합니다. 여기서는 알아보기 쉽게 ‘File’ 위젯에서 마우스 오른쪽 버튼을 클릭하고 ‘Rename’을 클릭한 후 위젯 이름을 ‘자장면소비자물가지수’라고 수정해 두었습니다.
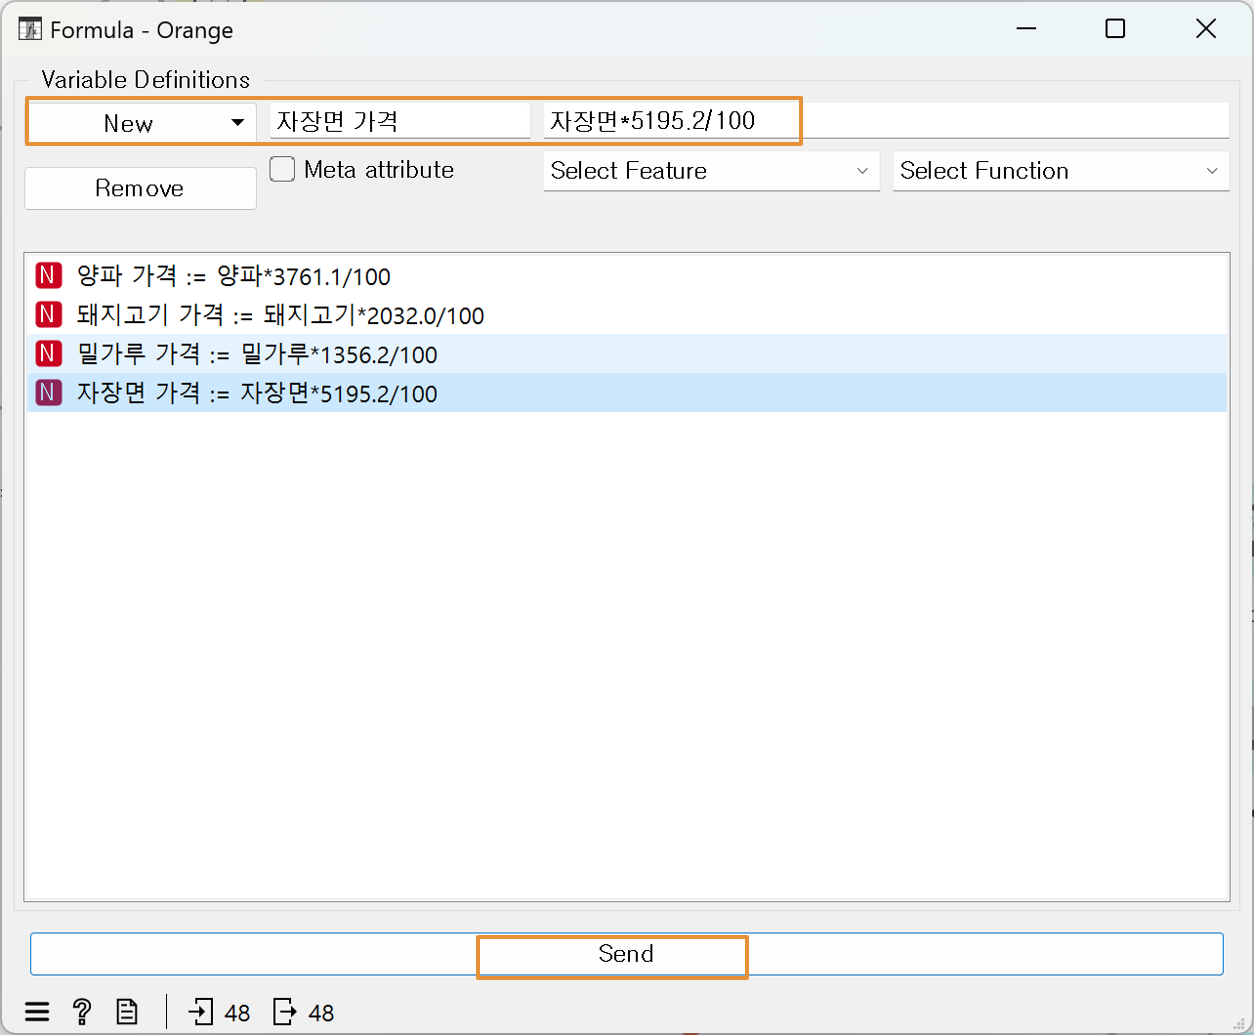
- ‘Formula’ 위젯을 더블클릭합니다. Formula 창에서 ‘New’ -> ‘Numeric’을 선택한 후 ‘자장면 가격’이라는 새로운 변수를 추가합니다. ‘자장면*5195.2/100’과 같은 수식으로 자장면 재료 가격을 계산하고 ‘Send’를 누릅니다. 양파, 돼지고기, 밀가루에 대해서도 같은 방식으로 계산식을 추가합니다.
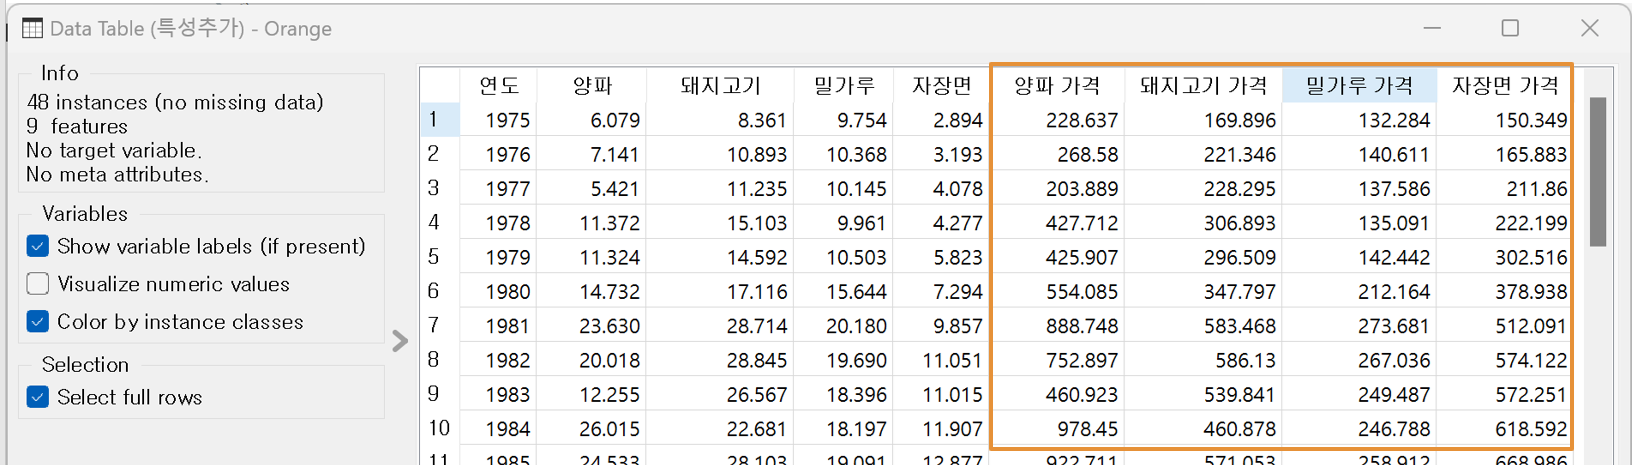
- ‘Formula’ 위젯에 ‘Data Table’ 위젯을 연결하면 그림과 같이 4가지 새로운 속성이 추가된 것을 확인할 수 있습니다.
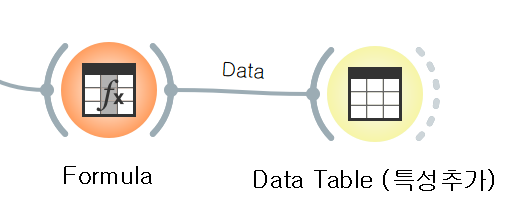
Formula로 자장면 가격 특성 추가
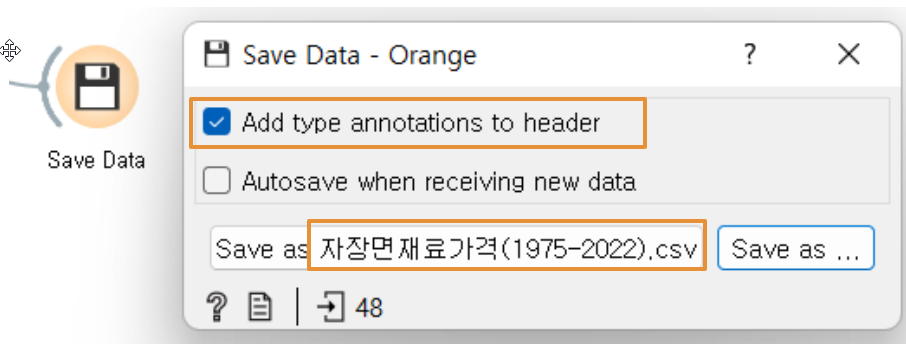
- ‘Save Data’ 위젯을 추가하고 ‘Formula’ 위젯과 연결합니다. ‘Save Data’ 위젯을 더블클릭해 변환된 데이터를 ‘자장면재료가격(1975-2022).csv’로 저장합니다.
2.2 독립변수와 종속변수 설정하기
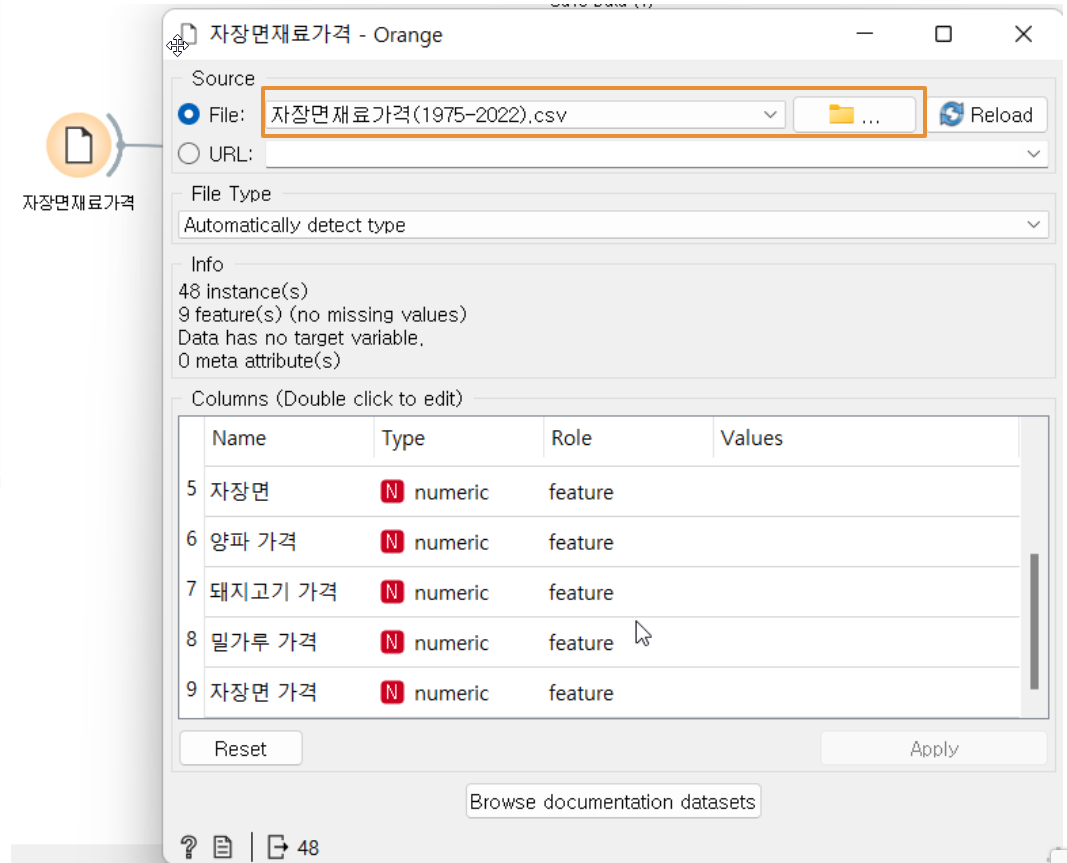
- ‘File’ 위젯을 새로 추가하고 앞서 저장한 ‘자장면재료가격(1975-2022).csv’ 파일을 불러옵니다. ‘File’ 위젯 이름을 ‘자장면재료가격’으로 수정하겠습니다.
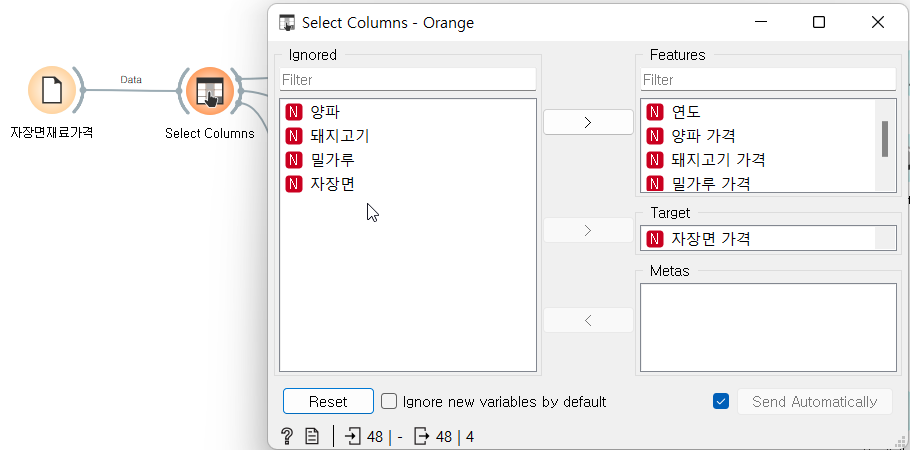
- 독립변수와 종속변수를 설정하기 위하여 ‘Transform’ 카테고리의 ‘Select Columns’ 위젯을 추가하고 ‘File’ 위젯(자장면재료가격)과 연결합니다. ‘Select Columns’ 위젯을 더블클릭합니다. 연도, 양파 가격, 돼지고기 가격, 밀가루 가격 속성은 독립변수(Feature)로 설정하고, 자장면 가격 속성은 종속변수(Target)로 설정합니다.
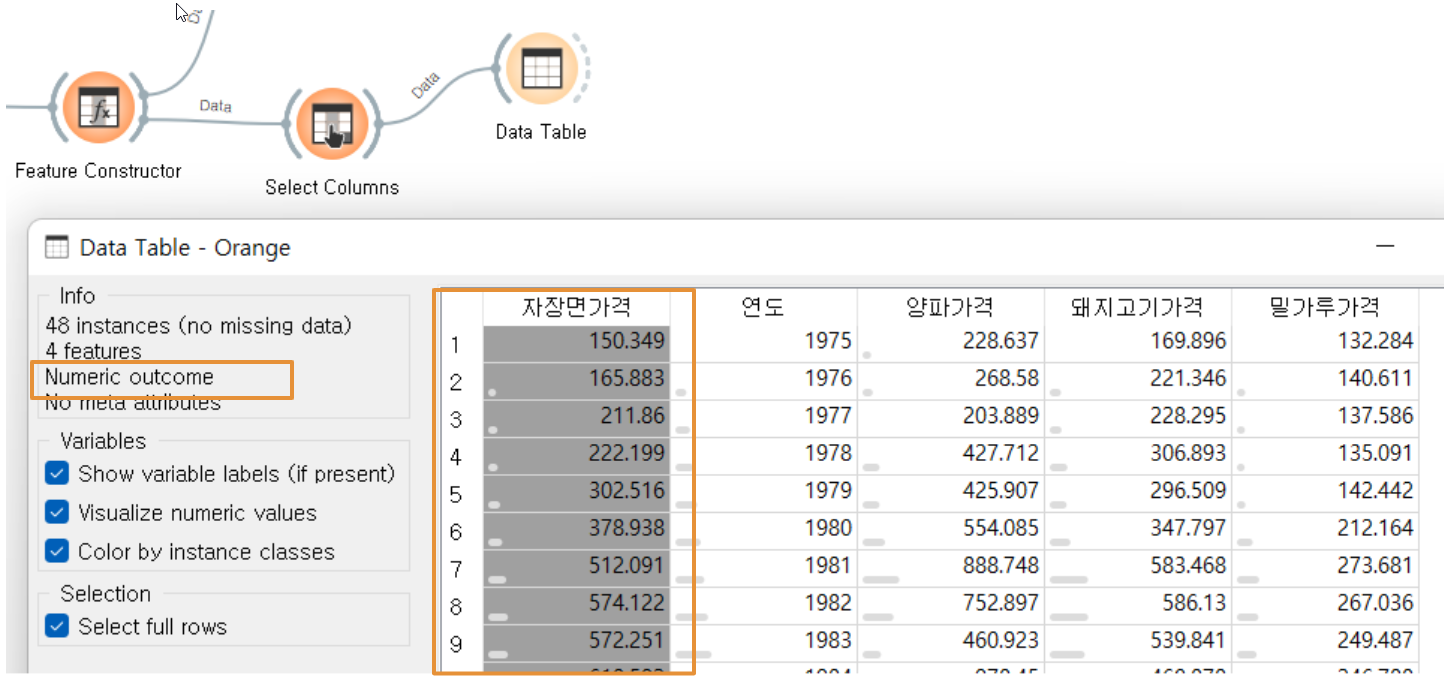
- ‘Select Columns’ 위젯에 ‘Data Table’ 위젯을 연결하고 데이터 테이블의 내용을 확인합니다. 종속변수로 설정된 자장면 가격 속성이 앞쪽에 나타나 있고, 왼쪽 Info 항목을 보면 Numeric Outcome이라고 표시되어 있습니다.
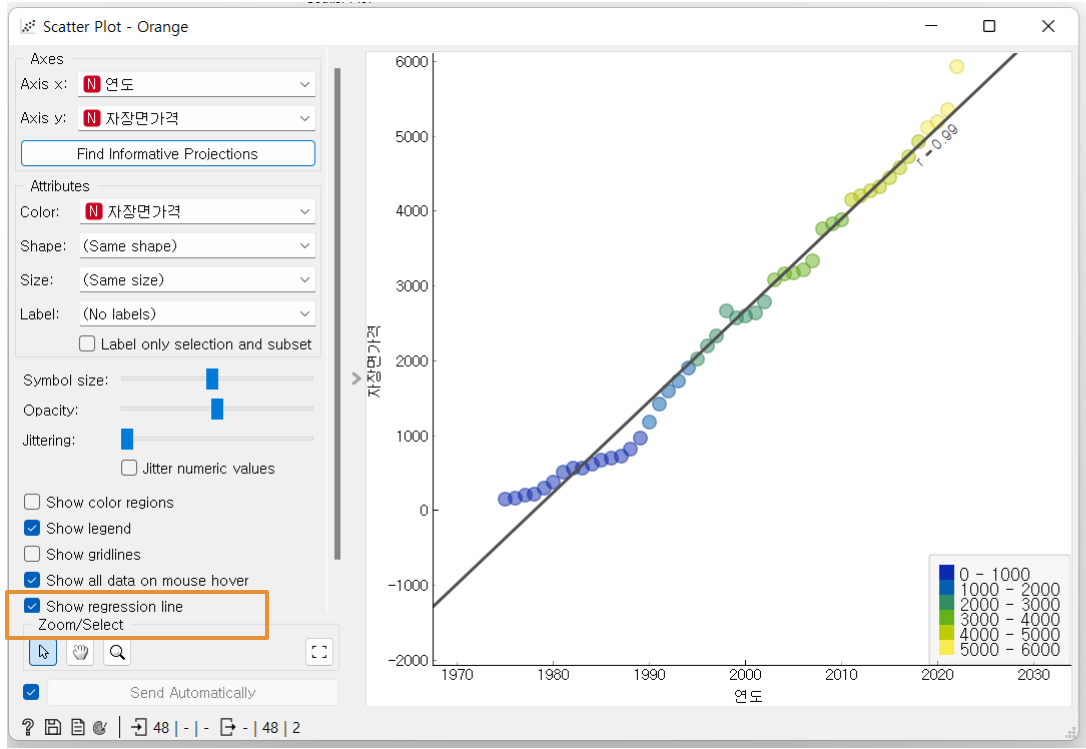
- 데이터 속성 간의 관계를 알아보기 위해 산점도를 표시해보겠습니다. ‘Visualize’ 카테고리의 ‘Scatter Plot’ 위젯을 추가하고 ‘Select Columns’ 위젯과 연결합니다. Scatter Plot 창을 열고 x축에 ‘연도’와 y축에 ‘자장면 가격’을 선택하면 데이터 속성 간의 상관관계를 확인할 수 있습니다. Show regression line에 체크하면 회귀선과 상관계수(r=0.99)를 보여줍니다. 상관관계를 통해 연도 속성이 자장면 가격을 예측하는 데 핵심 속성이 된다는 것을 말해줍니다.
연도와 자장면 가격의 상관관계
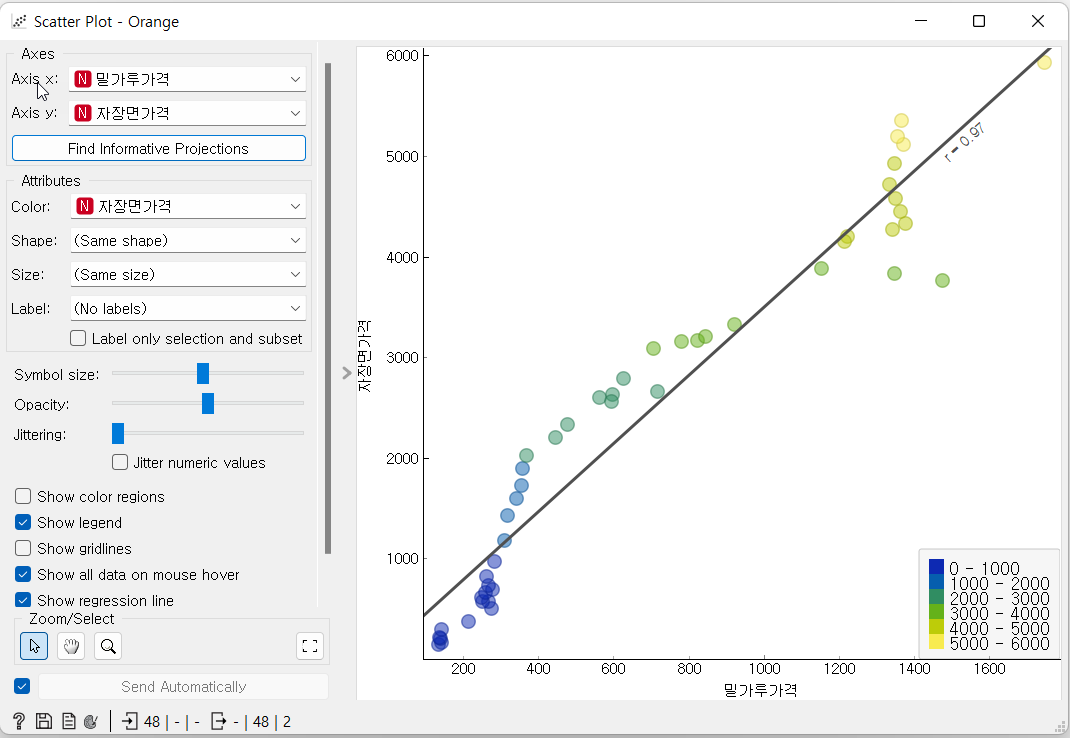
밀가루 가격과 자장면 가격의 상관관계
(더 배우기)
쉽게 배우는 AI 지식 : 상관계수
상관관계는 2개의 변수 x와 y가 있을 때 x의 변화에 따라 y도 변화하는 관계를 의미합니다.
상관계수는 상관관계가 얼마나 강한지를 나타내며 –1에서 1 사이의 값을 가집니다. r의 절대값이 1에 가까울수록 두 변수의 상관 관계가 높습니다. 다음 표는 상관계수의 상관 정도를 판단하는 기준을 보여줍니다.
상관 계수(r)
상관 정도
|r| < 0.2
거의 상관이 없다.
0.2 <= |r| < 0.4
약한 상관이 있다.
0.4 <= |r| < 0.6
상관이 있다.
0.6 <= |r| < 0.8
강한 상관이 있다.
|r| >= 0.8
매우 강한 상관이 있다.상관 계수(r) 상관 정도 |r| < 0.2 거의 상관이 없다. 0.2 <= |r| < 0.4 약한 상관이 있다. 0.4 <= |r| < 0.6 상관이 있다. 0.6 <= |r| < 0.8 강한 상관이 있다. |r| >= 0.8 매우 강한 상관이 있다. 상관 계수(r) 상관 정도 |r| < 0.2 거의 상관이 없다. 0.2 <= |r| < 0.4 약한 상관이 있다. 0.4 <= |r| < 0.6 상관이 있다. 0.6 <= |r| < 0.8 강한 상관이 있다. |r| >= 0.8 매우 강한 상관이 있다. 2.3 훈련 데이터와 테스트 데이터 분할하기
모델 학습과 성능 평가를 위해 훈련 데이터와 테스트 데이터로 분할하려고 합니다. ‘Transform’ 카테고리의 ‘Data Sampler’ 위젯을 추가하고 ‘Select Columns’ 위젯과 연결합니다. Data Sampler 창에서 훈련 데이터의 비율을 70%로 설정합니다.
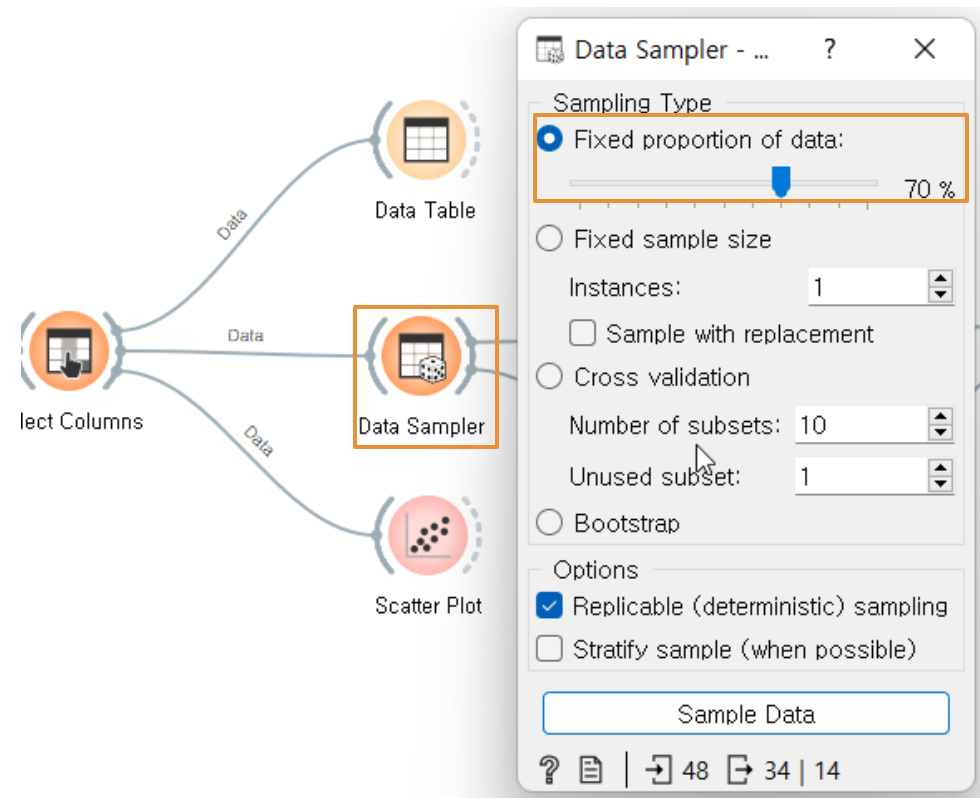
[3] 모델 학습과 성능 평가하기
3.1 선형회귀로 데이터 학습하기
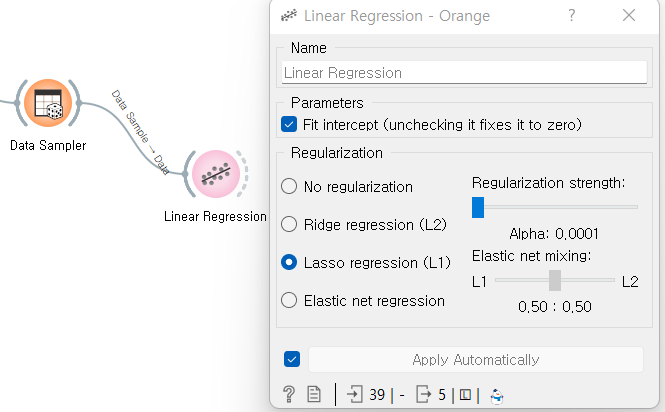
- ‘Data Sampler’ 위젯으로 분할한 훈련 데이터를 ‘Linear Regression’ 위젯에 연결합니다. 두 위젯의 연결 선을 더블클릭합니다. 전체 48개의 데이터 중 ‘Data Sampler’ 위젯에 의해 분할된 70%인 34개의 데이터가 선형회귀 모델 학습에 사용되는 것을 알 수 있습니다.
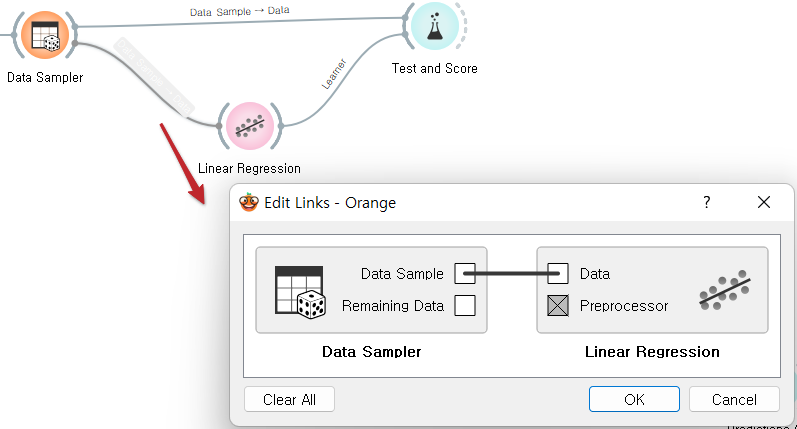
- ‘Linear Regression’ 위젯을 더블클릭하면 선형회귀의 정규화 옵션을 설정할 수 있습니다. 여기서는 Lasso regression(L1)을 선택합니다.
(더 배우기)
쉽게 배우는 AI 지식: Linear Regression 위젯
‘Linear Regression’ 위젯은 입력 데이터에서 선형 함수를 학습하는 학습자와 예측자를 구성합니다.
독립변수 X와 종속변수 Y 사이의 관계를 식별하여 선형회귀 모델을 생성합니다. 또한 Lasso 및 Ridge 정규화 매개변수를 지정할 수 있습니다.
[매개변수]
Fit intercept(절편 맞춤) 옵션을 선택하지 않으면 절편이 0이 됩니다.
[정규화]
Ridge와 Lasso 정규화는 모델의 과적합(Overfitting)을 방지하고 일반화 성능을 향상시키는 데 도움을 줍니다.
① Ridge regression(L2 정규화): L2 정규화는 모델의 가중치(weight)들을 제한하고, 각 가중치의 크기를 작게 만들어서 모델이 훈련 데이터에 과적합되는 것을 방지합니다.
② Lasso regression (L1 정규화): L1 정규화는 모델의 가중치들을 0으로 만드는 경향이 있습니다. 모델에서 중요하지 않은 특성들을 제거하는 역할을 하여, 특성 선택(feature selection) 효과를 얻을 수 있습니다.
③ Elastic net regression: Ridge의 L2와 Lasso의 L1 정규화를 혼합한 것입니다.
* Ridge는 입력변수가 전반적으로 비슷한 수준으로 출력변수에 영향을 미치는 경우 사용하고, Lasso의 경우 입력변수의 가중치 차이가 큰 경우에 사용합니다.3.2 선형회귀 모델 성능 평가하기
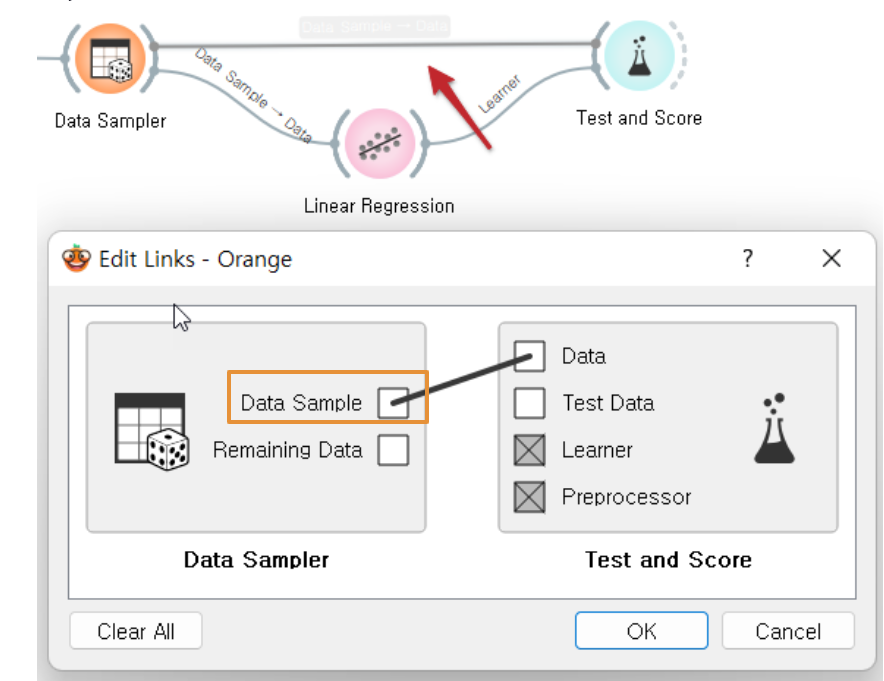
- 모델 학습한 결과를 확인하기 위해 ‘Test and Score’ 위젯을 연결합니다. 이때 ‘Data Sampler’ 위젯으로 분할한 전체 데이터 중 훈련 데이터로 사용한 70%의 데이터로 성능을 검증합니다. 두 위젯의 연결 선을 더블클릭해 훈련 데이터로 학습한 모델의 성능을 확인합니다.
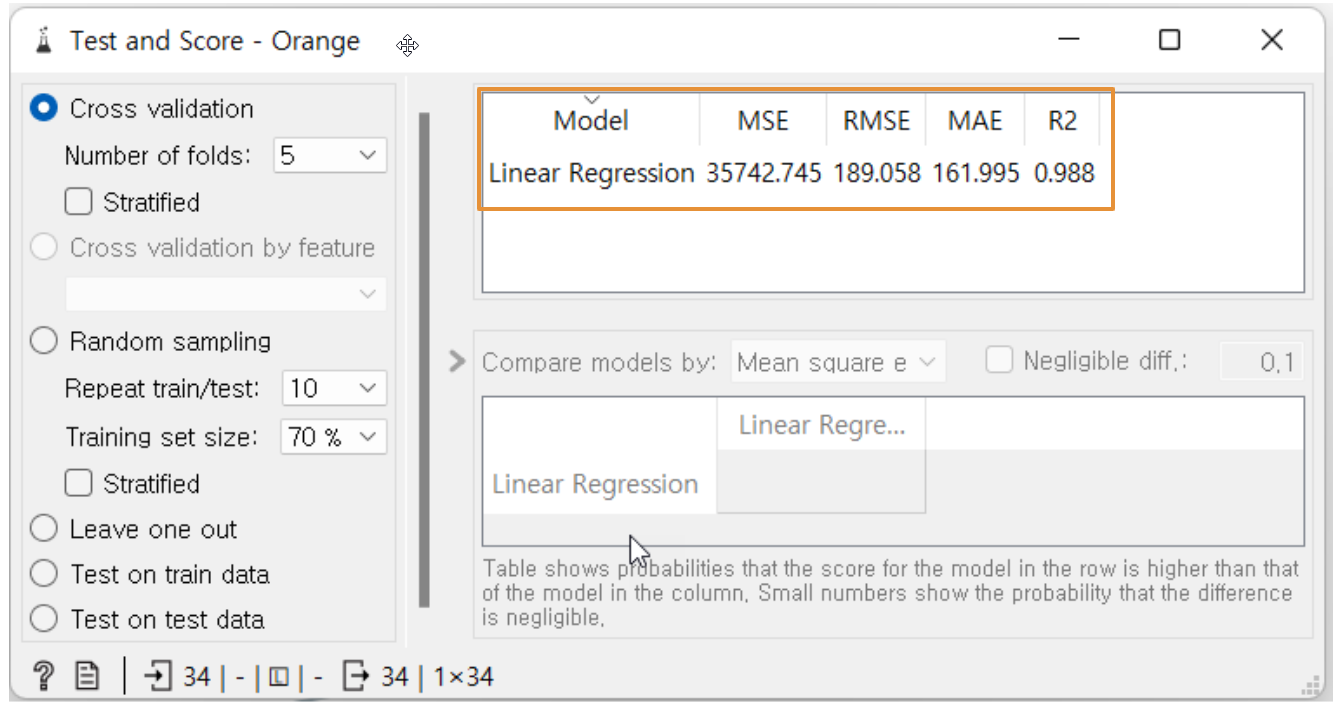
- ‘Test and Score’ 위젯을 더블클릭하면 34개의 훈련 데이터로 학습한 모델의 학습 결과를 확인할 수 있습니다. 선형회귀 모델의 성능을 확인할 수 있는 4가지 지표값을 보여줍니다. 그중 모델이 실제 데이터를 얼마나 잘 설명하는지 나타내는 결정계수()는 0.988로 나타났습니다.
③ ‘Linear Regression’ 위젯에 ‘Data Table’ 위젯을 연결하면 선형회귀 모델의 회귀계수와 절편을 확인할 수 있습니다. 학습을 통해 생성된 선형회귀 모델을 식으로 나타내면 다음과 같습니다.
자장면 가격을 예측하는 모델은 연도가 가장 큰 영향을 미치는 것으로 나타났습니다. 자장면 재료 중에는 밀가루 가격, 양파 가격순으로 영향을 주고 있습니다.
[4] 모델 평가 및 예측하기
- 학습이 이루어진 모델에 테스트 데이터를 입력하여 모델의 성능을 평가하기 위하여 전체 데이터 중 남은 데이터를 사용하도록 ‘Predictions’ 위젯에 추가해 연결합니다. 연결선을 더블클릭하고 다음과 같이 Remaining Data를 사용하도록 데이터 연결을 변경합니다.
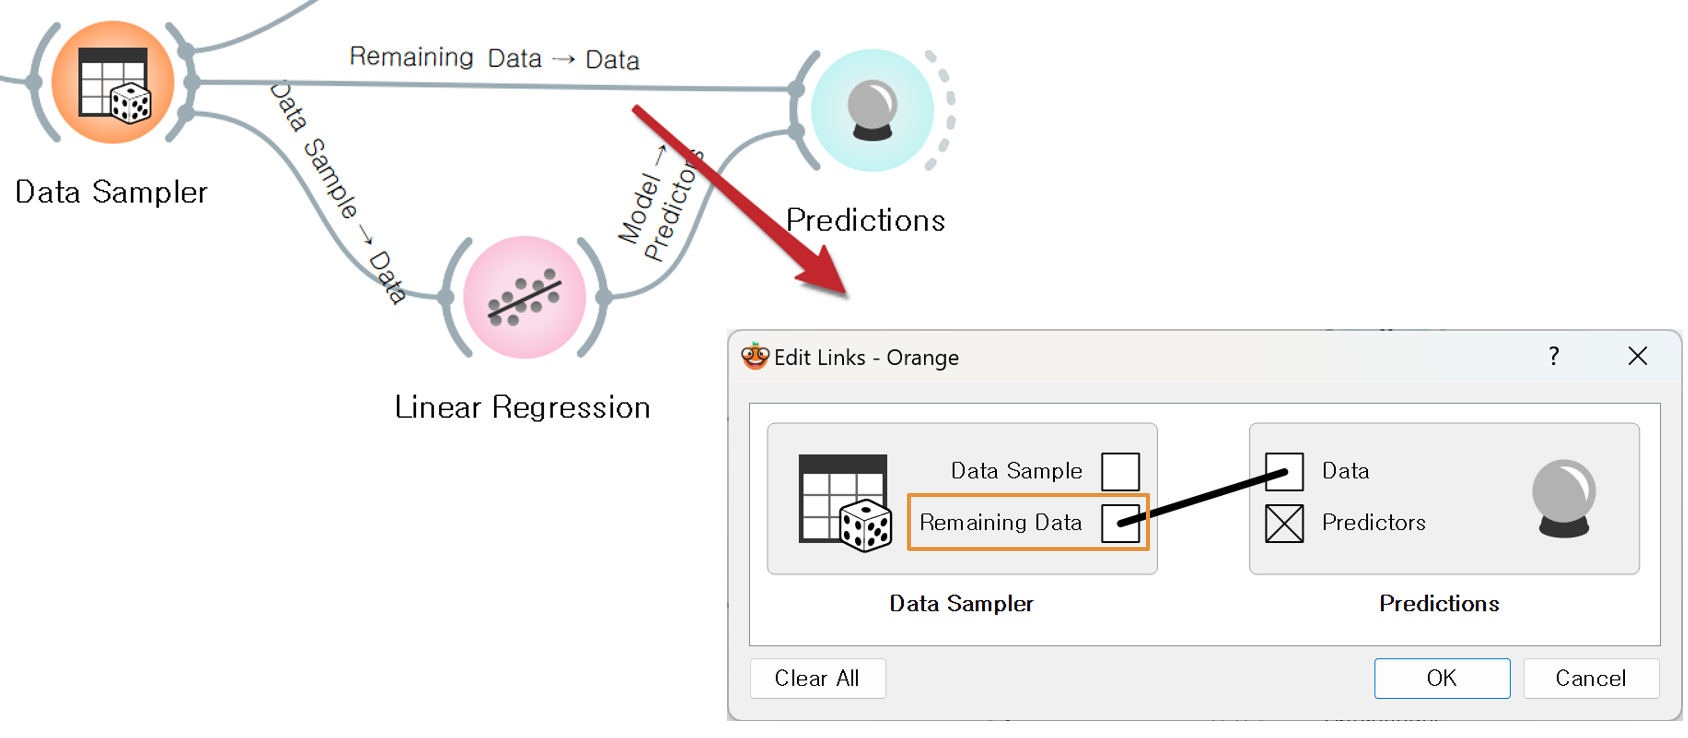
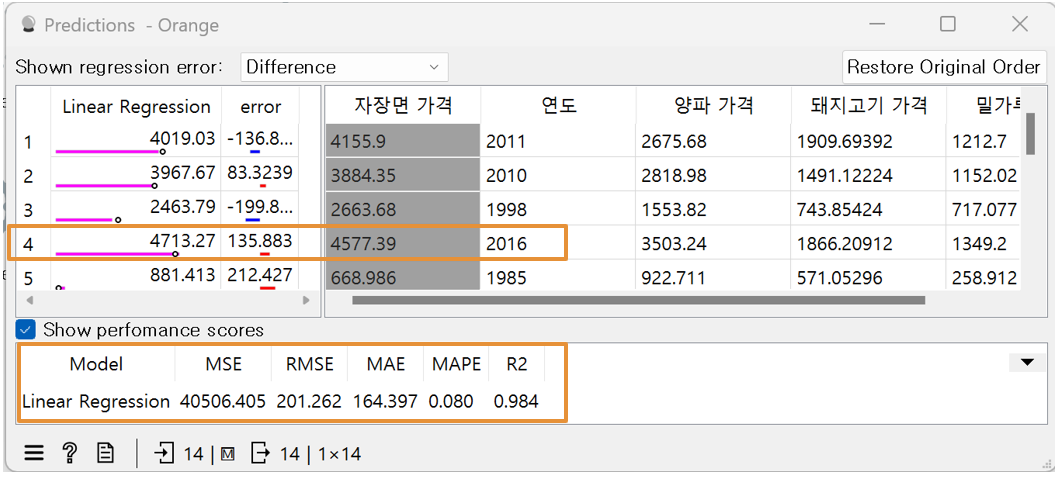
- ‘Predictions’ 위젯을 더블클릭하면 모델의 성능평가 결과를 확인할 수 있습니다. 선형회귀 모델의 성능평가지표인 결정계수()의 값이 0.984로 높게 나타났습니다. ‘Predictions’ 위젯을 활용하면 실제 자장면 가격과 선형회귀 모델이 예측한 자장면 가격을 비교해 볼 수 있습니다. 2016년 실제 자장면 가격은 4,577원인데 선형회귀 모델이 예측한 값은 4713.27로 약간의 오차가 있습니다.
테스트 데이터의 성능평가 및 예측 결과
[5] 모델 활용하기
이렇게 만들어진 모델을 활용하여 2030년과 2040년, 2050년 자장면 가격을 예측해보겠습니다. 이를 위해 2030, 2040, 2050년 양파, 돼지고기, 밀가루 가격을 단순 선형회귀로 예측하여 ‘new_data.csv’ 파일에 저장하였습니다.
[표 3-6] 새로운 데이터(new_data.csv)
| 연도 | 양파 가격 | 돼지고기 가격 | 밀가루 가격 |
| 2030 | 4168.29 | 2371.04 | 1752.68 |
| 2040 | 4923.95 | 2794.36 | 2095.70 |
| 2050 | 5679.62 | 3217.69 | 2418.72 |
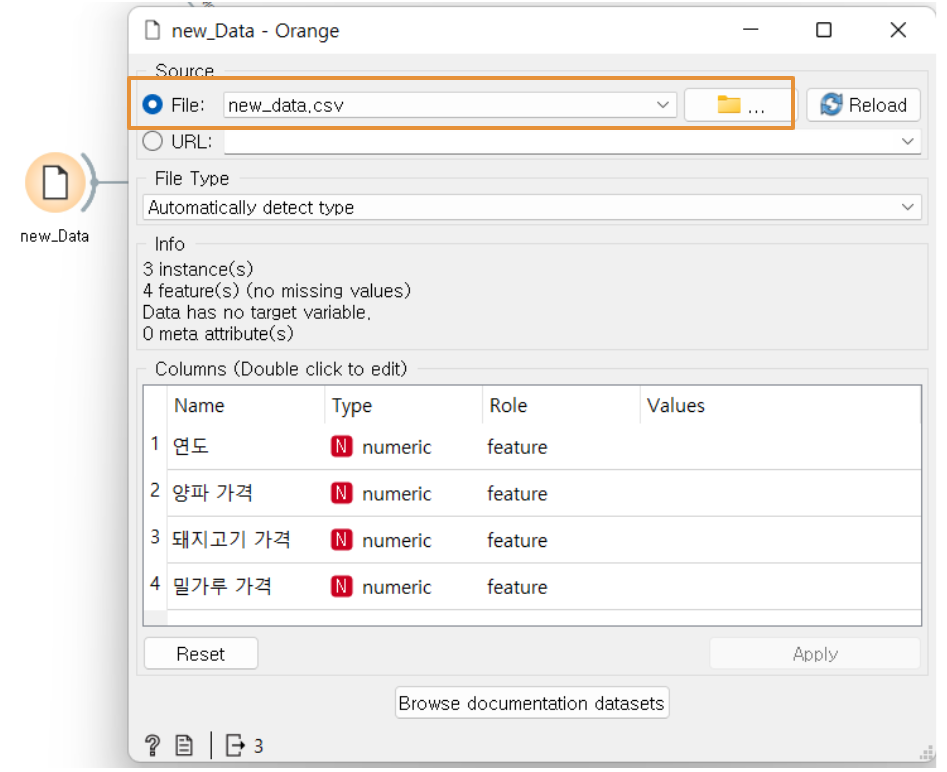
- ‘File’ 위젯을 새로 추가합니다. 여기서는 위젯 이름을 ‘new_Data'로 변경했습니다. 이 위젯을 더블클릭하고 새로운 데이터(new_data.csv)를 가져옵니다. 자장면 가격을 예측하기 위한 데이터이므로 4가지 속성(Role)은 모두 feature로 설정합니다.
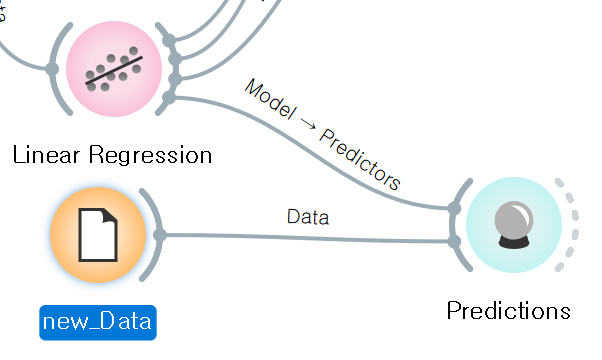
- 2040년 자장면 가격을 예측하기 위해 그림과 같이 선형회귀 모델의 출력과 새로운 데이터를 ‘Predictions’ 위젯에 연결합니다. ‘Predictions’ 위젯을 더블클릭하면 인공지능이 예측한 결과를 보여줍니다.
선형회귀 모델의 예측 결과
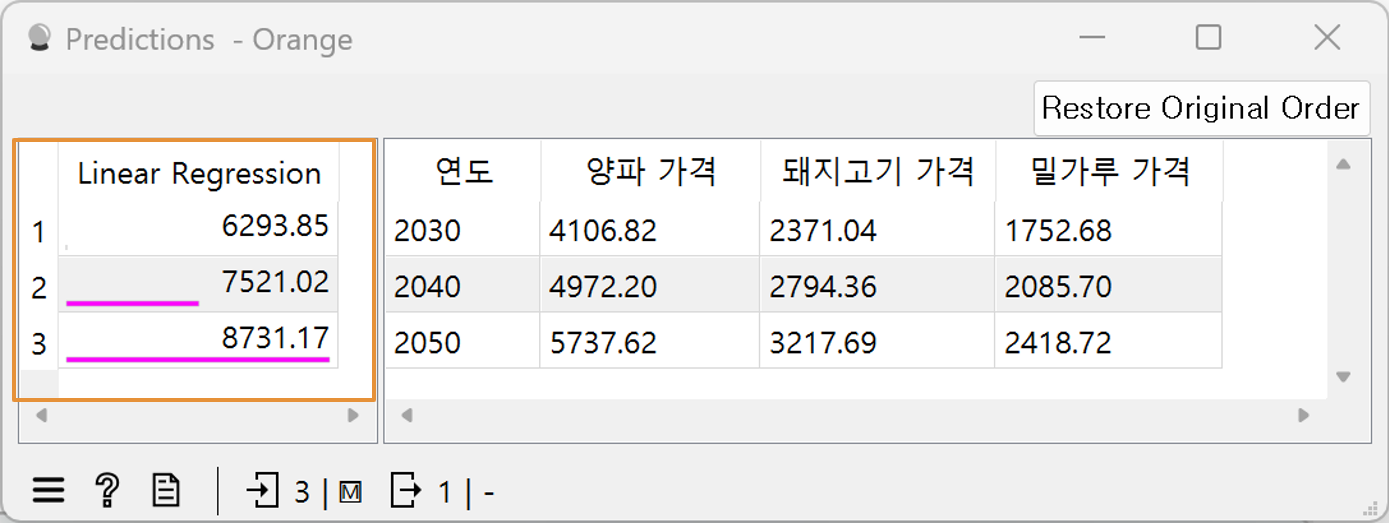
선형회귀 모델은 2040년 자장면 가격은 7,521원으로 예측하였습니다.
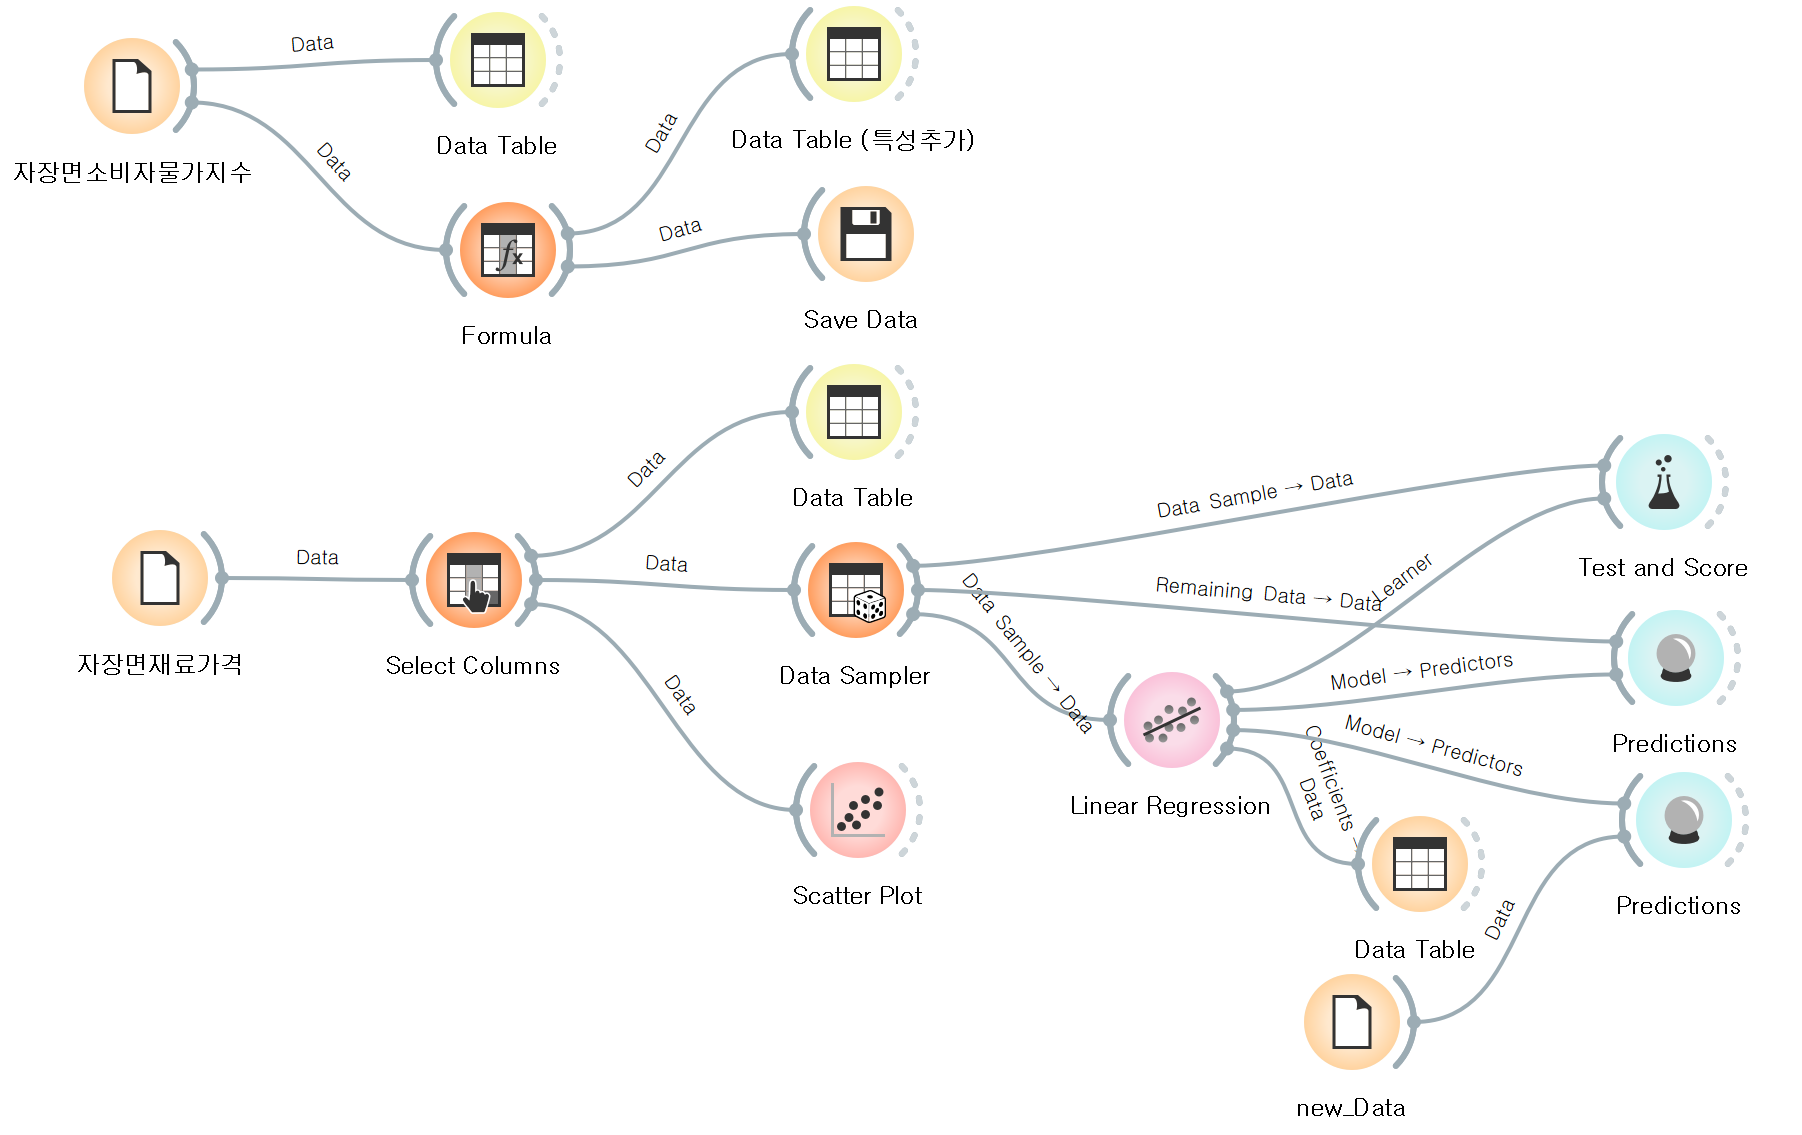
오렌지로 2040년 자장면 가격을 예측하는 모델을 구현하는 과정은 다음과 같습니다.
오렌지3를 이용한 2040년 자장면 가격 예측 모델 구현 과정
(더 배우기)
쉽게 배우는 AI지식: 선형회귀 모델 성능평가 지표
만화로 알아보는 성능평가 지표
실제값과 모델이 예측한 값의 차이를 오차라고 해. 평균제곱오차(MSE)는 오차를 제곱하여 값을 구한 것이야. 오차가 커지만 MSE 값이 매우 크거나 작아지게 되지.
평균제곱오차제곱근(RMSE)는 값이 커지거나 작은 값이 될 수 있으니 그 값에 제곱근을 취한 값으로 나타낸 지표야.
평균절대오차(MAE)는 오차에 절대값을 취하여 평균을 구한 값이야. 오차에 절대값을 취한 지표야.
그럼 너희가 보여주는 값는 어느 정도 되어야 좋은 것이니? 결정계수(R2)는 모델이 실제값을 얼마나 잘 설명하는지 나타내는 지표인데, 1에 가까울수록 성능이 좋아.
[그림 3-6] 선형 회귀의 성능평가 지표
(편집자주: 그려주세요)
모델이 얼마나 성능이 좋은지 성능을 평가하기 위해 나 , 와 같은 지표를 사용합니다. 실제값 와 모델이 예측한 값 를 비교하여 모델의 성능을 평가합니다.
, 는 y값의 평균입니다.
오차는 0에 가까울수록, 은 1에 가까울수록 좋은 모델입니다.
성능평가지표 의미 수학적 계산 MSE 평균제곱오차 RMSE 평균제곱오차의 제곱근 MAE 평균절대오차 결정계수
6. 파이썬을 이용해 선형회귀 모델 구현하기
이제 구글 코랩에서 파이썬으로 이 문제를 선형회귀 모델로 구현해 보겠습니다.
[1] 데이터 불러오기
1.1 파일 업로드하기
자장면 재료의 연도별 소비자물가지수는 ‘자장면소비자물가지수(1975-2022).csv’ 파일에 저장되어 있습니다. 구글 코랩에서 다음 코드를 입력한 후 ‘자장면소비자물가지수(1975-2022).csv’ 파일을 업로드합니다.
from google.colab import files
uploaded = files.upload()
csv 파일에 저장된 데이터를 읽어오기 위해 판다스 라이브러리를 가져옵니다.
import pandas as pd파일에서 데이터를 읽어서 데이터프레임에 저장합니다. 속성명이 한글로 저장되어 있기 때문에 encoding=‘cp949’를 추가합니다. 혹시 인코딩 오류가 발생할 경우 encoding=‘cp949’를 삭제하고 다시 실행해보세요.
df=pd.read_csv('자장면소비자물가지수(1975-2022).csv', encoding='cp949')
df.head()
데이터프레임 df에 저장된 자장면 물가지수의 상위 5개 자료를 출력하면 다음과 같습니다.
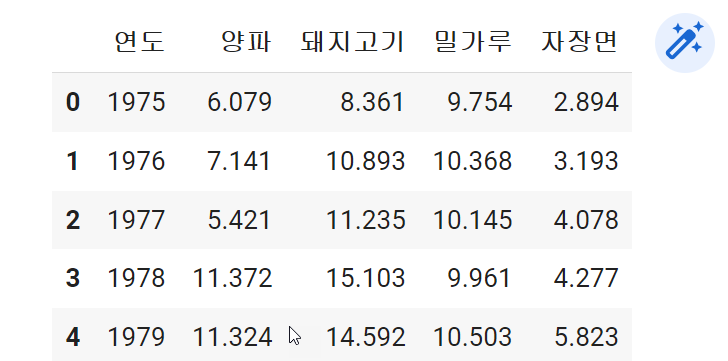
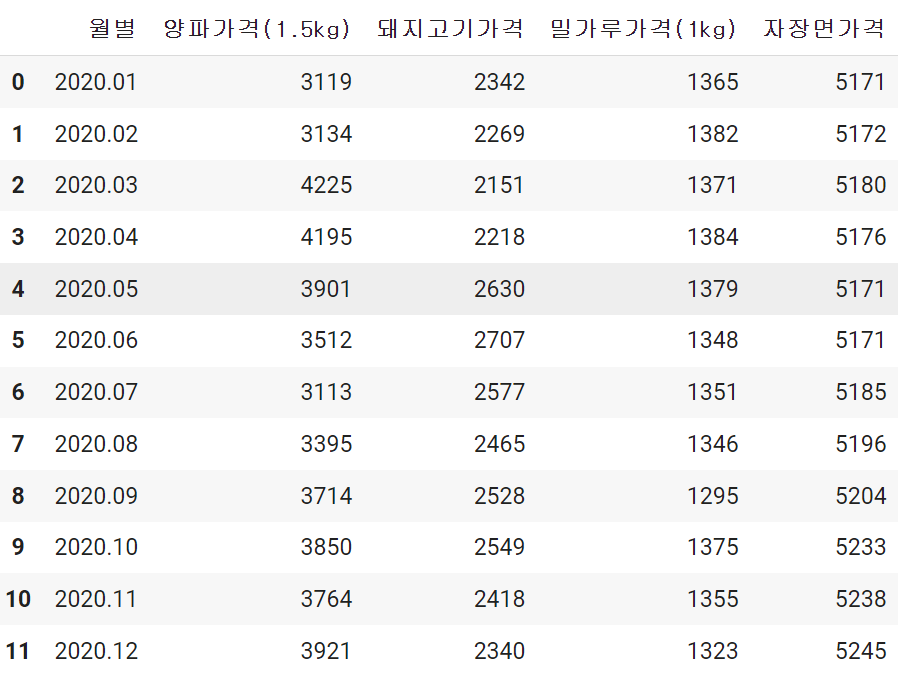
2020년 자장면 재료 가격 데이터도 불러와서 데이터프레임1(df1)에 저장합니다.
df1=pd.read_csv('자장면재료가격2020.csv', encoding='cp949')df1
[2] 데이터 탐색과 전처리하기
2.1 데이터 둘러보기
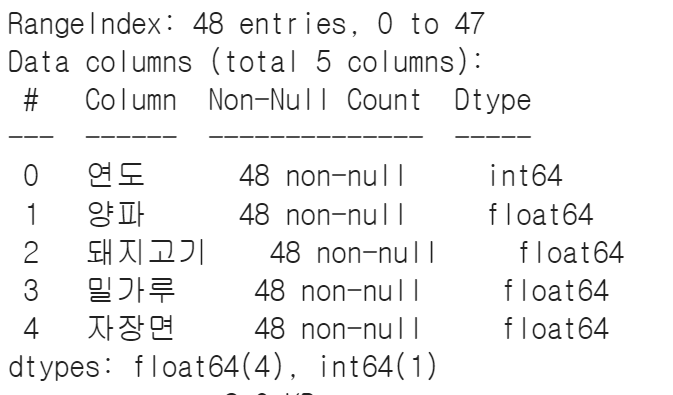
df 데이터프레임의 info() 함수를 이용하여 정보를 살펴보면 자장면 소비자물가지수 데이터는 48행 5개의 속성으로 이루어져 있습니다.
df.info() #데이터 속성 정보를 확인합니다.
df 데이터프레임의 describe() 함수를 이용하여 자장면 소비자물가지수의 평균, 표준편차, 최소값, 최대값과 같은 통계값을 확인할 수 있습니다.
df.describe()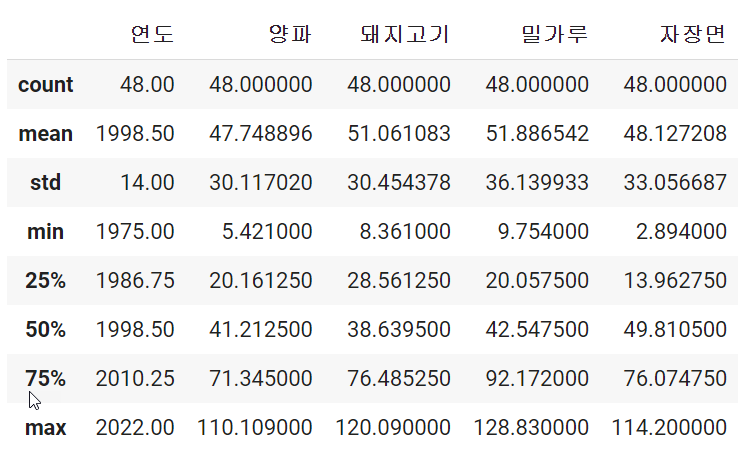
2.2 데이터 전처리하기
자장면 재료의 소비자물가지수 데이터를 가격 데이터로 변환하기 위해 데이터 전처리가 필요합니다.
[표 3-7] 2020년 자장면 재료별 소비자 가격
| 연도 | 양파 가격(1.5kg) | 돼지고기 가격 | 밀가루 가격(1kg) | 자장면 가격 |
| 2020년 | 3761.1 | 2032.0 | 1356.2 | 5195.2 |
price2020=[3761.1, 2032.0, 1356.2, 5195.2] # 2020년 자장면 재료가격
2020년 자장면 재료가격을 이용하여 연도별 자장면 재료가격을 계산합니다.
df['양파 가격']=round(df['양파']*price2020[0]/100,2)
df['돼지고기 가격']=round(df['돼지고기']*price2020[1]/100,2)
df['밀가루 가격']=round(df['밀가루']*price2020[2]/100,2)
df['자장면 가격']=round(df['자장면']*price2020[3]/100,2)round(값,2): 소수점 세 번째 자리에서 반올림하여 두 번째 자리까지 출력합니다.
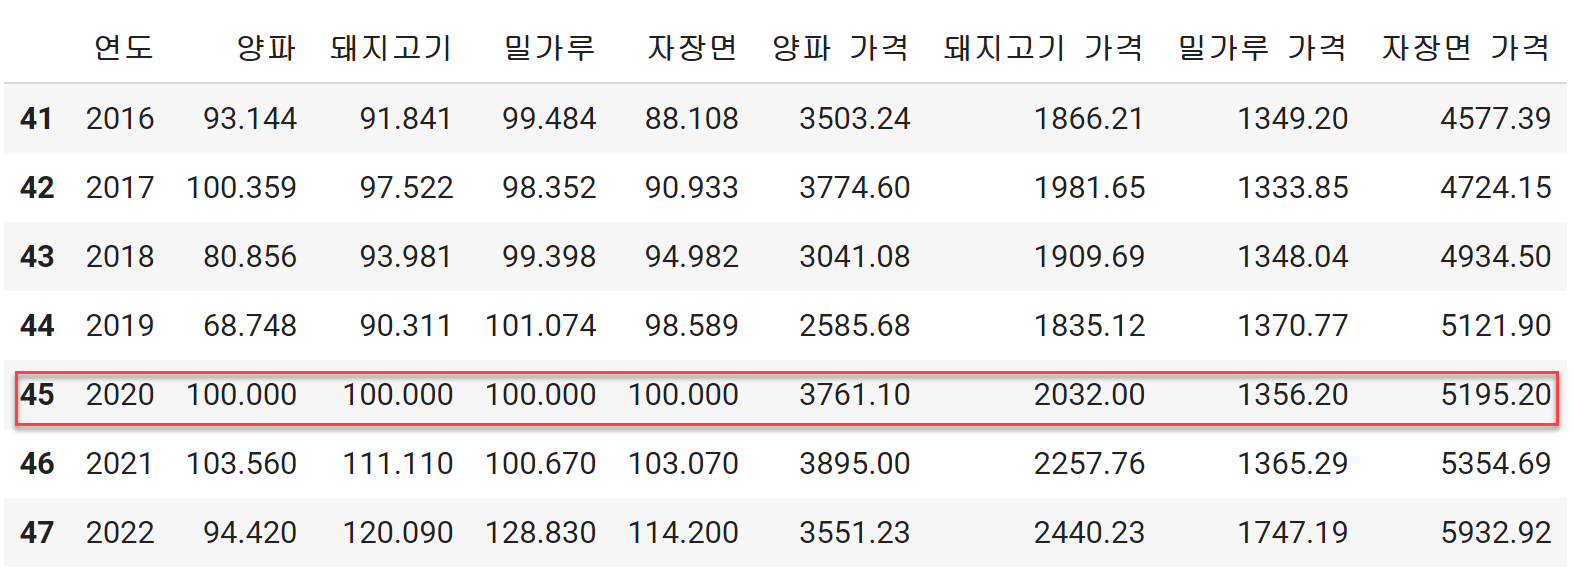
위와 같은 명령어로 새로운 속성을 추가한 후 출력해보면 다음과 같습니다. 2020년 소비자물가지수는 ‘100’이고, 가격은 ‘price2020’에 저장된 값과 같습니다.
df[41:48] #데이터프레임의 index 41행부터 47행까지 출력됩니다.
2.3 탐색적 데이터 분석하기
- 자장면 재료 가격 속성 추출하기
df 데이터프레임에서 연도와 자장면 재료 가격을 추출하여 df2 데이터프레임에 저장합니다.
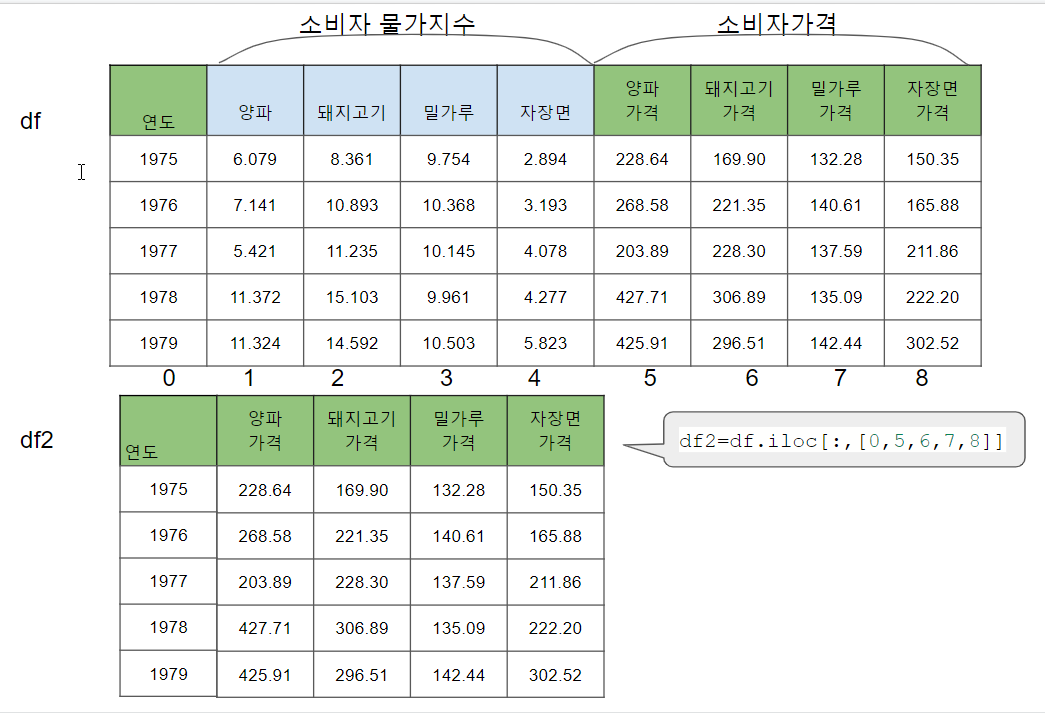
df2=df.iloc[:,[0,5,6,7,8]] df2.head()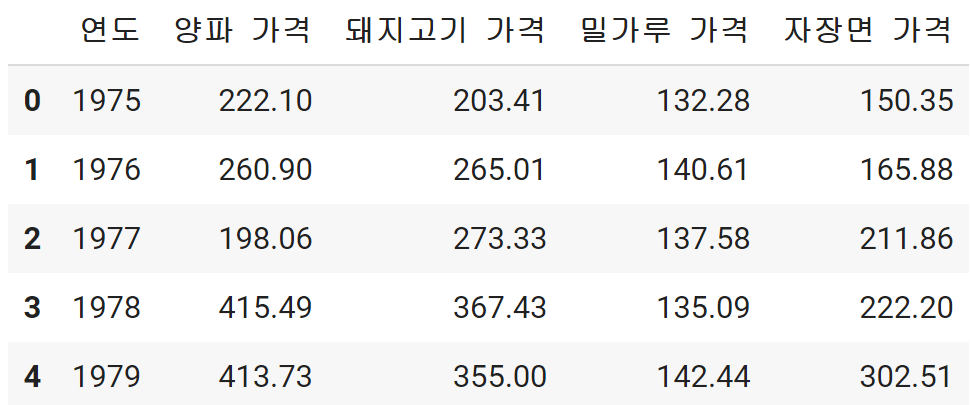 참고
df2=df.iloc[:,[0,5,6,7,8]]: 데이터 테이블에서 열 인덱스를 이용하여 특정 속성을 추출합니다. 그림과 같이 데이터프레임(df)의 0, 5, 6, 7, 8번 속성 데이터를 추출하여 df2에 저장합니다.
df2=df.iloc[:,[0,5,6,7,8]](편집자주: 그려주세요)
- 데이터 시각화하기
데이터 속성 간의 관계를 파악하기 위하여 상관관계를 출력해보면 다음과 같습니다.
df2.corr()자장면 가격은 연도와 상관관계가 0.99로 상관관계가 매우 높고, 다음으로 밀가루 가격과 상관관계가 높다는 것을 알 수 있습니다. 돼지고기 가격과 양파 가격도 상관관계가 높습니다.
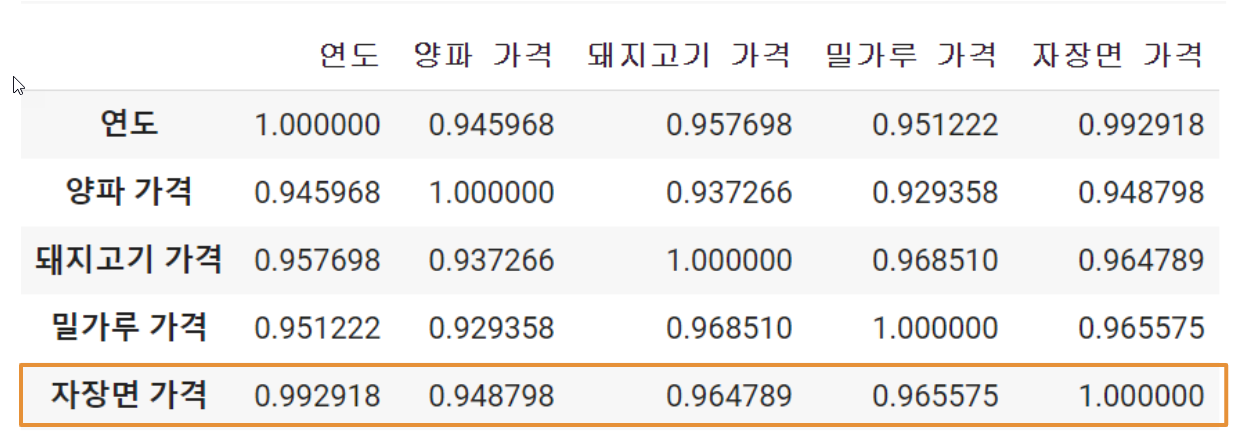 참고
df2.corr(): corr() 함수는 데이터프레임의 모든 속성 간의 상관관계를 찾습니다.
이와 같은 상관관계 계산 결과를 히트맵(heatmap)으로 시각화하면 다음과 같습니다.
!pip install koreanize-matplotlib # 한글 폰트 라이브러리 추가
import koreanize_matplotlib
import matplotlib.pyplot as plt
import seaborn as sns
sns.heatmap(df2.corr(), annot=True, cmap='Greens')
히트맵을 살펴보면 자장면 가격은 연도와 상관관계가 0.99로 가장 높았고, 밀가루 가격, 돼지고기 가격, 양파 가격순으로 상관관계가 높습니다.
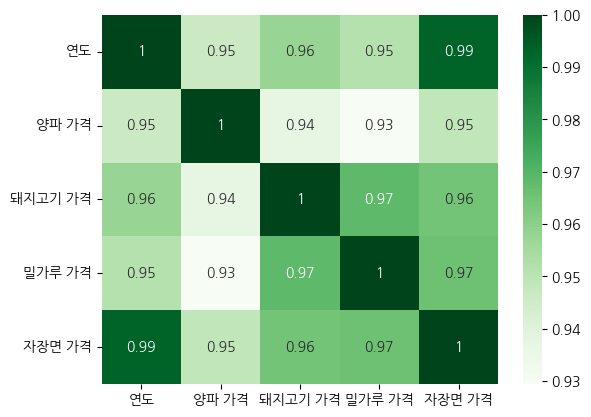 참고
heatmap: 데이터들의 관계를 색상으로 표현해주는 그래프입니다. 변수들 간의 관계를 직관적으로 나타냅니다.
annot: True/False로 셀의 값 표시 여부를 설정합니다.
cmap='Greens': 맵(map)의 색을 초록색 계열로 나타냅니다.또한 전체 속성들 간의 관계를 pairplot으로 나타내면 다음과 같습니다. 분포를 살펴보면 자장면 가격은 밀가루 가격과 상관관계가 높습니다.
sns.pairplot(df2)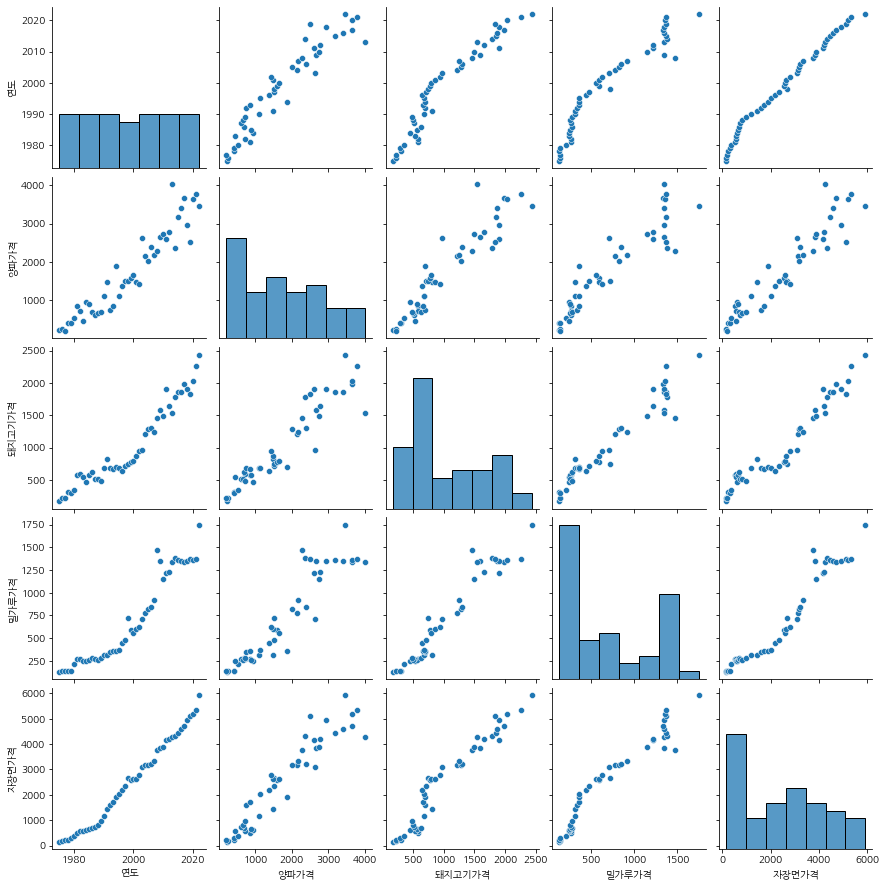
2.4 독립변수와 종속변수 설정하기
연도, 밀가루 가격, 양파 가격, 돼지고기 가격을 독립변수로, 자장면 가격을 종속변수로 하는 다중 선형회귀 모델을 구현하기 위해 연도, 양파 가격, 돼지고기 가격, 밀가루 가격을 X로, 자장면 가격을 y로 설정하였습니다.
X=df2.iloc[:, 0:4] # X 독립변수: 연도, 양파 가격, 돼지고기 가격, 밀가루 가격
y=df2.iloc[:,4] # y 종속변수: 자장면 가격
X를 출력하면 다음과 같이 4개의 속성으로 이루어져 있습니다.
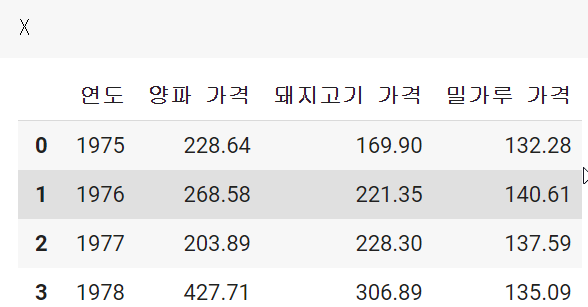 참고
X=df2.iloc[:, 0:4]: X 변수에 df2 데이터프레임의 모든 행과 0, 1, 2, 3 속성의 값이 저장됩니다.
y=df2.iloc[:,4]: y 변수에 모든 행의 4번 속성 값이 저장됩니다.2.5 훈련 데이터와 테스트 데이터 분할하기
훈련 데이터와 테스트 데이터를 분할하기 위해 사이킷런의 train_test_split을 가져옵니다. 훈련 데이터와 테스트 데이터의 비율을 7:3으로 설정합니다.
from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test=train_test_split(X,y,test_size=0.3, random_state=42)참고데이터를 분할할 때 훈련 데이터(X), 테스트 데이터(X), 훈련 데이터(y), 테스트 데이터(y)의 순서대로 기술하는 것에 주의합니다.
test_size=0.3 : 훈련 데이터와 테스트 데이터의 비율을 7:3으로 분할하도록 설정합니다.
[3] 모델 학습하기
사이킷런의 LinearRegression 라이브러리를 가져와서 모델 학습을 수행합니다.
from sklearn.linear_model import LinearRegression
model=LinearRegression()
model.fit(X_train, y_train)
print(model.coef_, model.intercept_) # coef_는 계수, intercept_는 절편model.fit(): 훈련 데이터(X_train, y_train)로 학습합니다.
model.coef_와 intercept_는 완성된 모델의 계수와 절편의 값을 의미합니다.
위 코드의 실행 결과, 모델의 계수와 편향 값은 다음과 같이 출력됩니다.

다음과 같은 명령어를 실행하면 회귀계수와 절편을 다음과 같이 출력할 수 있습니다.
for i in range(4):
print("w%d = %.3f"%(i+1,model.coef_[i]))
print("b = %.3f"%(model.intercept_))model.fit(): 훈련 데이터(X_train, y_train)로 학습합니다.
model.coef_와 intercept_는 완성된 모델의 계수와 절편의 값을 의미합니다.
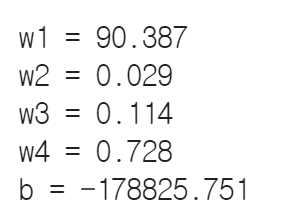
위의 출력 결과를 바탕으로, 연도를 , 양파 가격을 , 돼지고기 가격을 , 밀가루 가격을 라고 할 때 자장면 가격()을 예측하는 선형회귀 모델의 식은 다음과 같습니다.
자장면 가격을 예측하는 선형회귀 모델은 연도의 가중치가 가장 높다는 것을 알 수 있습니다.
[4] 모델 성능 평가하기
이렇게 만들어진 모델은 실제값을 얼마나 정확하게 예측할까요? 훈련 데이터와 테스트 데이터를 이용하여 모델이 얼마나 데이터를 잘 설명해 주는지 확인해보겠습니다.
# 훈련 데이터와 테스트 데이터로 성능평가
print('Accuracy score(Train data) :',end=' ')
print(model.score(X_train, y_train))         # 훈련 데이터로 성능평가
print('Accuracy score(Test data) :',end=' ')
print(model.score(X_test, y_test))           # 테스트 데이터로 성능평가
model.score()는 으로 모델 적합도를 평가한 것입니다. 훈련 데이터와 테스트 데이터 모두 0.98로 나타나 신뢰할 수 있는 모델이라고 말할 수 있습니다.
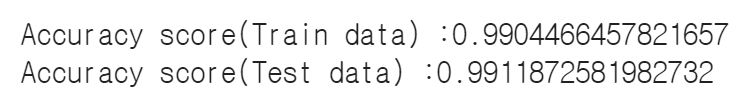
model.score(): 모델의 성능평가 지표 중 결정계수()의 값을 나타냅니다.
매개변수에는 x값과 y값을 입력합니다.
평균제곱오차(MSE), R2, 평균절대오차(MAE)의 성능평가지표를 확인해보겠습니다.
from sklearn.metrics import mean_squared_error, r2_score, mean_absolute_error
y_pred=model.predict(X_test)
print('Mean squared error :', mean_squared_error(y_pred, y_test))
print('Mean absolute error :', mean_absolute_error(y_pred, y_test))
print('R2 score : ', r2_score(y_pred, y_test))
위 코드의 출력 결과는 다음과 같습니다.
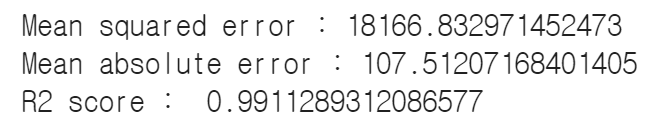
mean_squared_error(): 모델이 예측한 값(y_pred)과 실제값(y_test)의 평균제곱오차를 계산합니다.
mean_absolute_error(): 모델이 예측한 값(y_pred)과 실제값(y_test)의 평균절대오차를 계산합니다.
r2_score(): 모델이 예측한 값(y_pred)과 실제값(y_test) 결정계수를 계산합니다.
테스트 데이터의 실제값(y_test)과 선형회귀 모델이 예측값(y_pred)을 비교하여 성능을 평가한 결과는 다음과 같습니다. 오렌지3에서 계산한 모델의 성능과 어떤 차이가 있는지 확인해볼 수 있습니다.
[표 3-8] 자장면 가격 예측 선형회귀 모델의 성능평가 결과
| 성능평가지표 | MSE | MAE | |
| 성능평가 값 | 18166.832 | 107.512 | 0.991 |
[5] 모델 활용 문제 해결하기
이제 처음에 설정한 문제를 해결해봅시다.
2040년 자장면 가격을 예측할 수 있을까?
2030년, 2040년, 2050년 자장면 재료 가격이 저장된 새로운 데이터를 불러옵니다.
df_new=pd.read_csv('new_data.csv', encoding='cp949')df_new
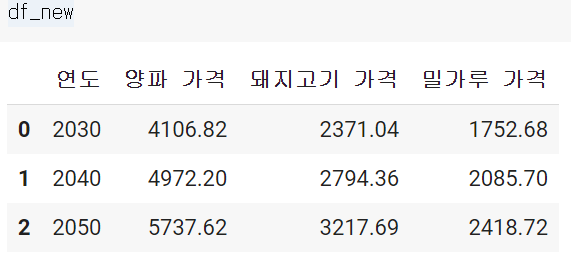
인공지능은 미래의 자장면 가격을 어떻게 예측할까요? 새로운 데이터를 입력하면 2030년, 2040년, 2050년 자장면 가격을 다음과 같이 예측합니다.
print(model.predict(df_new))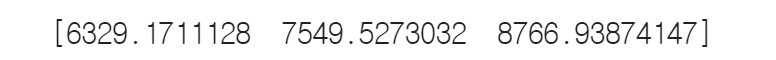
우리가 구현한 선형회귀 모델은 2040년 자장면 가격을 7549.52원으로 예측합니다.
전체 코드는 다음과 같습니다.
import pandas as pd
df=pd.read_csv('자장면소비자물가지수(1975-2022).csv', encoding='cp949')
df.head()
# 데이터 살펴보기
df
df.info()
# 데이터프레임 통계 정보 확인
df.describe()
# 자장면 재료별 소비자물가지수를 가격 데이터로 변환
price2020=[3761.1, 2032.0, 1356.2, 5195.2]
df['양파 가격']=round(df['양파']*price2020[0]/100,2)
df['돼지고기 가격']=round(df['돼지고기']*price2020[1]/100,2)
df['밀가루 가격']=round(df['밀가루']*price2020[2]/100,2)
df['자장면 가격']=round(df['자장면']*price2020[3]/100,2)
# 데이터에서 연도와 가격 속성만 추출하여 df2에 저장
df2=df.iloc[:,[0,5,6,7,8]]
df2.head() # 데이터프레임의 앞에서 5개 값 확인하기
# 속성 간 상관관계 출력
df2.corr()
# 상관관계를 히트맵으로 시각화
!pip install koreanize-matplotlib # 한글 폰트 설정이 필요 없는 라이브러리 추가
import koreanize_matplotlib
import matplotlib.pyplot as plt
import seaborn as sns
sns.heatmap(df2.corr(),annot=True, cmap='Greens')
# df2 데이터 프레임에서 독립변수와 종속변수 역할 설정
X=df2.iloc[:,0:4]
y=df2.iloc[:,4]
# 훈련 데이터와 테스트 데이터 분할
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test=train_test_split(X,y, test_size=0.3, random_state=42)
# 사이킷런의 LinearRegression 모델 가져오기
from sklearn.linear_model import LinearRegression
model=LinearRegression()
model.fit(X_train, y_train) # 모델 학습
# 모델 회계계수와 절편 출력하기
print(model.coef_, model.intercept_)  # 회귀계수와 절편 출력하기
for i in range(4):                     # 회귀계수 값을 구체적으로 출력하기
print("w%d = %.3f"%(i+1,model.coef_[i]))
print("b = %.3f"%(model.intercept_))
# 훈련 데이터와 테스트 데이터 모델 성능(R2) 비교
print('Accuracy score(Train data) :',end='')
print(model.score(X_train, y_train))   # 훈련 데이터로 성능평가
print('Accuracy score(Test data) :',end='')
print(model.score(X_test, y_test))     # 테스트 데이터로 성능평가
#다양한 모델 성능평가지표 출력
from sklearn.metrics import mean_squared_error, mean_absolute_error,r2_score
y_pred=model.predict(X_test)
print('Mean squared error :', mean_squared_error(y_pred, y_test))
print('Mean absolute error :', mean_absolute_error(y_pred, y_test))
print('R2 score : ', r2_score(y_pred, y_test))
# 2030년, 2040년, 2050년 자장면 가격 예측
df_new=pd.read_csv('new_data.csv', encoding='cp949')
df_new
print(model.predict(df_new))| 이번 장에서는 2040년 자장면 가격을 예측하는 선형회귀 모델을 구현하였습니다. 이를 위해 품목별 소비자물가지수와 2020년 자장면 재료 가격 데이터를 수집하여 기계학습에 필요한 형태로 전처리합니다. 데이터 속성 간의 상관관계를 비교한 결과 자장면 가격과 연도가 가장 상관관계가 높은 것으로 나타났고, 밀가루 가격도 상관관계가 높게 나타났습니다. 자장면 가격 수치를 예측하는 문제를 해결하기 위해 다중선형회귀 모델을 구현하였습니다. 오렌지로 구현한 다중선형회귀 모델은 2040년 자장면 가격을 7,521원으로 예측했습니다. 파이선으로 구현한 다중선형회귀 모델은 2030년 자장면 가격을 7549.52원으로 예측하였습니다. from sklearn.linear_model import LinearRegression model=LinearRegression() | from sklearn.linear_model import LinearRegression model=LinearRegression() | |
| from sklearn.linear_model import LinearRegression model=LinearRegression() |